Amazon Mitra-v2 — Modèles de fondation tabulaires et fine-tuning
Last reviewed: 19 septembre 2026
Les modèles de fondation tabulaires existent en deux familles : ceux qui répondent tout de suite (zéro-shot, comme TabFM de Google) et ceux qu'on spécialise sur ses propres données en quelques minutes. Mitra-v2, publié par Amazon, appartient à la seconde : 77 millions de paramètres, entraîné uniquement sur des données synthétiques, et conçu pour le fine-tuning. Cet article explique comment il fonctionne, ce qu'il apporte face à un projet de data science classique, et où il se situe face à TabFM — avec le même cas d'usage sénégalais que l'article compagnon : la production solaire d'une maison à Badoudou, près de Sokone.
Ce que vous allez comprendre
- Ce qu'est un prior synthétique mixte, et pourquoi c'est le cœur de Mitra.
- Comment une régression peut se traiter comme une classification sur 1 000 intervalles, et pourquoi cela donne des prévisions avec incertitude.
- La différence entre modèle généraliste (zéro-shot) et modèle spécialiste (fine-tuning).
- Ce que disent les benchmarks publics, et comment lire une comparaison de modèles sans se faire piéger.
- Quand fine-tuner vaut le coup… et quand ce ne vaut pas le coup.
Prérequis : avoir lu, ou survoler, l'article Google TabFM qui pose les notions de base (apprentissage en contexte, modèle de fondation, protocole de test).
1. Rappel : pourquoi les modèles tabulaires ont besoin d'un « prior »
Un modèle de fondation généraliste apprend sur des millions de tâches synthétiques. La qualité de ces tâches — leur distribution a priori, leur prior — détermine ce que le modèle saura faire plus tard sur vos données réelles.
Deux stratégies se dessinent :
- Parier sur la variété extrême : générer des tables très diverses et compter sur l'apprentissage en contexte pour s'adapter à tout, sans jamais modifier les poids. C'est la voie TabPFN / TabFM.
- Parier sur la diversité plus la spécialisation : générer des priors synthétiques mixtes (plusieurs familles de générateurs, dont un prior causal hybride), puis laisser l'utilisateur ajuster quelques pas de fine-tuning sur sa propre tâche. C'est la voie Mitra.
Mitra-v1 (« Mixed synthetic priors for enhancing tabular foundation models », 2025) a montré que des priors plus divers produisent un modèle qui se spécialise mieux et plus vite. Mitra-v2 pousse la logique : distribution de pré-entraînement beaucoup plus large, contexte dix fois plus long, trois fois plus de variables.
2. Architecture : un Transformer 2D compact
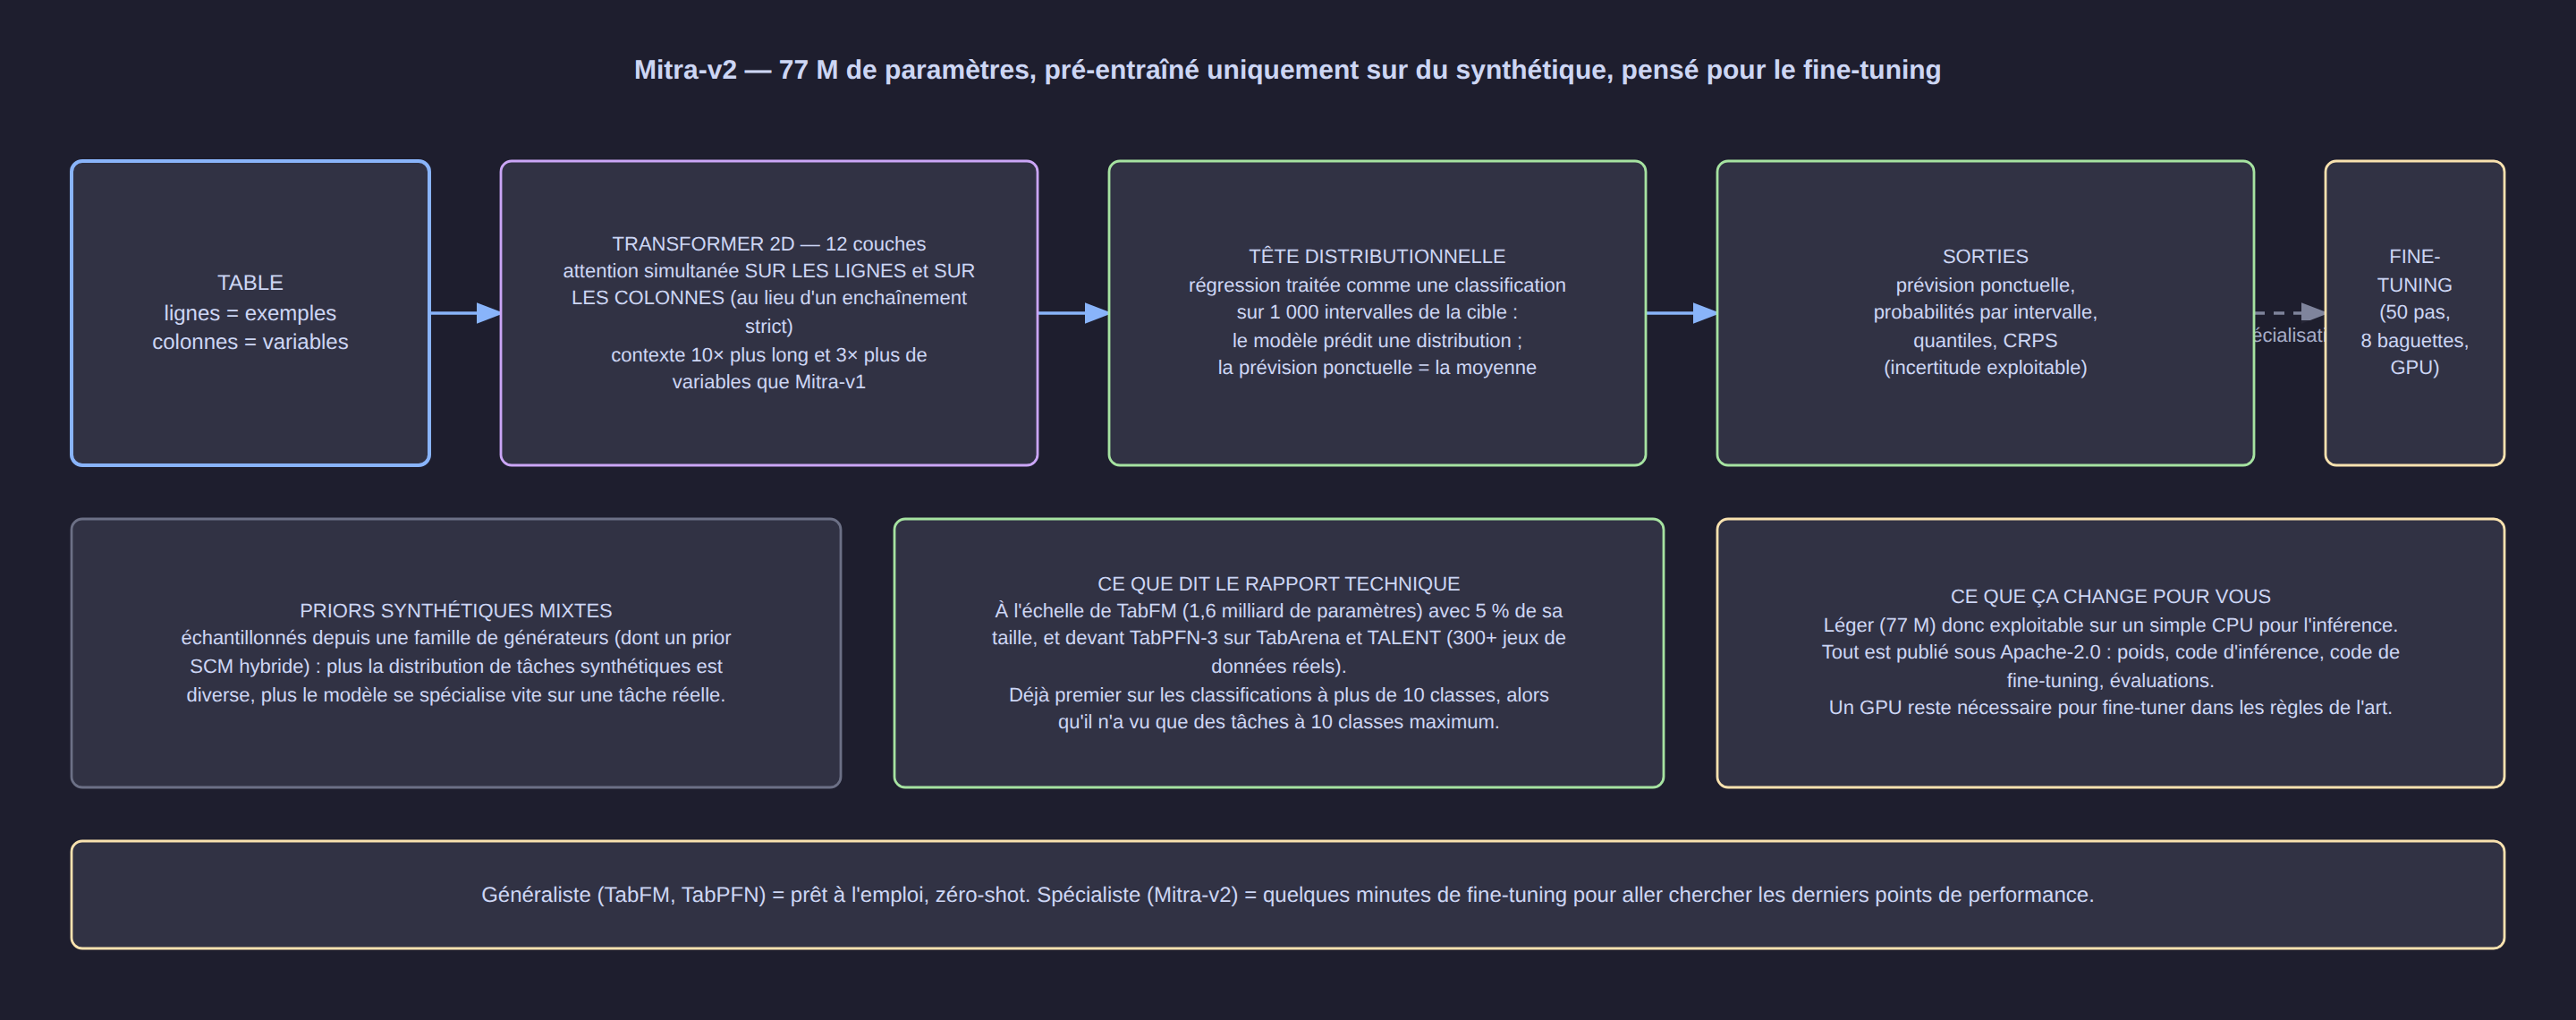
Les points à retenir, sans jargon inutile :
- 12 couches, 76,7 millions de paramètres. Pour comparaison, TabFM annonce 1,6 milliard de paramètres : Mitra-v2 vise la performance à une fraction du coût d'exécution.
- Attention « 2D ». Le modèle fait attention à la fois sur les lignes et sur les colonnes : une ligne, c'est un exemple ; une colonne, c'est une variable. Beaucoup d'architectures tabulaires traitent ces deux directions l'une après l'autre ; ici l'information circule dans les deux sens à chaque couche.
- Contexte long. Les lignes d'entraînement sont passées au modèle comme contexte (apprentissage en contexte), dix fois plus de lignes que dans la version 1 — c'est ce qui permet de travailler sur des jeux de données réels, pas seulement sur des jouets.
- Tête distributionnelle à 1 000 intervalles. C'est l'idée la plus élégante : pour une régression, au lieu de prédire directement une valeur, Mitra-v2 découpe la cible en 1 000 intervalles et prédit une probabilité pour chacun. La prévision ponctuelle est la moyenne de cette distribution.
Conséquence pratique : on n'obtient pas seulement « 14,2 kWh », mais une distribution — donc des quantiles, des intervalles de confiance, et la possibilité de dire « j'ai 80 % de chances de produire plus de 11 kWh demain ». Pour un dimensionnement solaire, c'est exactement ce dont on a besoin : on ne dimensionne pas une batterie sur une moyenne, mais sur les mauvais jours.
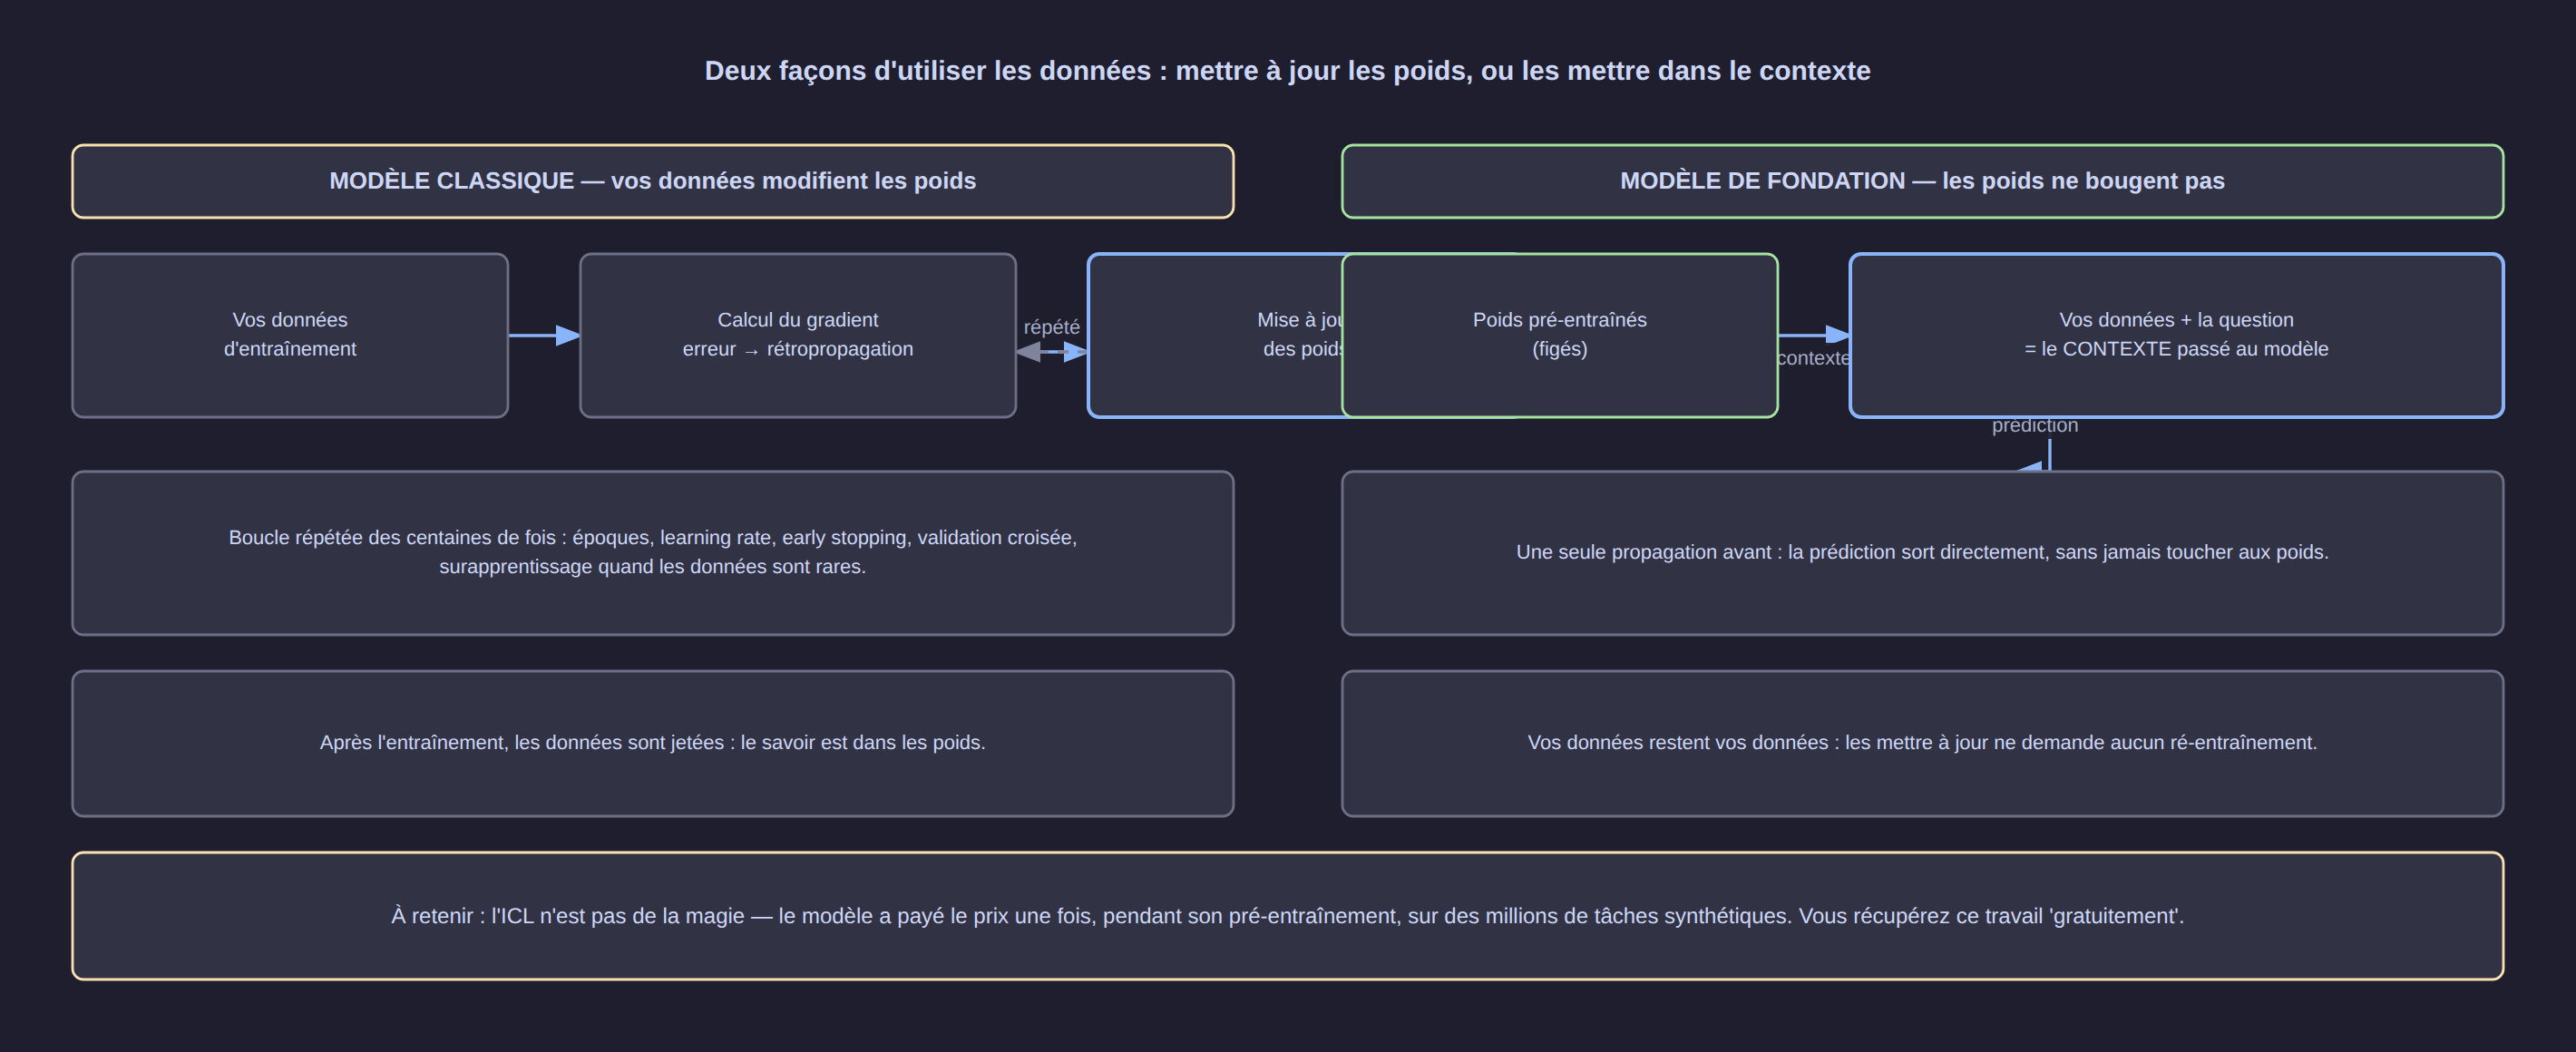
3. Généraliste ou spécialiste : deux façons d'utiliser un modèle de fondation
| Généraliste (zéro-shot) | Spécialiste (fine-tuning) | |
|---|---|---|
| Exemples | TabFM, TabPFN | Mitra-v2 |
| Ce qui change pendant l'usage | rien : les poids sont figés | les poids sont ajustés sur vos données |
| Effort | aucun réglage | recette d'entraînement à lancer |
| Matériel | CPU suffisant pour un petit jeu | GPU nécessaire (la recette publiée utilise le GPU) |
| Gain attendu | très bon immédiatement | les derniers points de performance, sur un domaine précis |
| Risque principal | licence et limites du domaine vu à l'entraînement | surapprentissage si les données sont rares |
La recette de référence publiée pour Mitra-v2 est 50 pas de fine-tuning avec 8 copies « baguées » (8-fold bagging) : le modèle est ajusté huit fois sur des sous-échantillons, et les huit prédictions sont moyennées. Cela réduit la variance — la principale ennemie quand on a peu de données.
# Environnement d'inférence / fine-tuning de Mitra-v2
uv pip install "autogluon.tabular[mitra]>=1.6" "tabarena>=0.1.0"
[!NOTE] Licence. Mitra-v2 est publié sous Apache-2.0 : les poids, le code d'inférence, le code de fine-tuning et les résultats d'évaluation. C'est une différence notable avec des poids sous licence non commerciale : ici, l'usage en production est permis sans négociation préalable.
4. Ce que disent les benchmarks (et comment les lire)
Mitra-v2 est évalué sur TabArena et TALENT, deux ensembles de benchmarks réunissant plus de 300 jeux de données réels (risque de crédit, prédiction clinique, détection de panne d'équipement, estimation de prix immobiliers…), sous deux protocoles d'évaluation.
Les résultats annoncés par les auteurs :
- performance de l'ordre de TabFM et d'EXAONE Tabular (les meilleurs modèles de la catégorie), devant TabPFN-3 sur TabArena, en classification comme en régression ;
- 5 % de la taille de TabFM (77 M contre 1,6 Md de paramètres) pour une performance comparable ;
- sur TALENT, parmi les premiers, devant TabPFN-3 et TabICLv2 ;
- premier sur les classifications à plus de 10 classes, alors que le modèle n'a été pré-entraîné que sur des tâches comportant au maximum dix classes — un signe que l'apprentissage de structure se transfère.
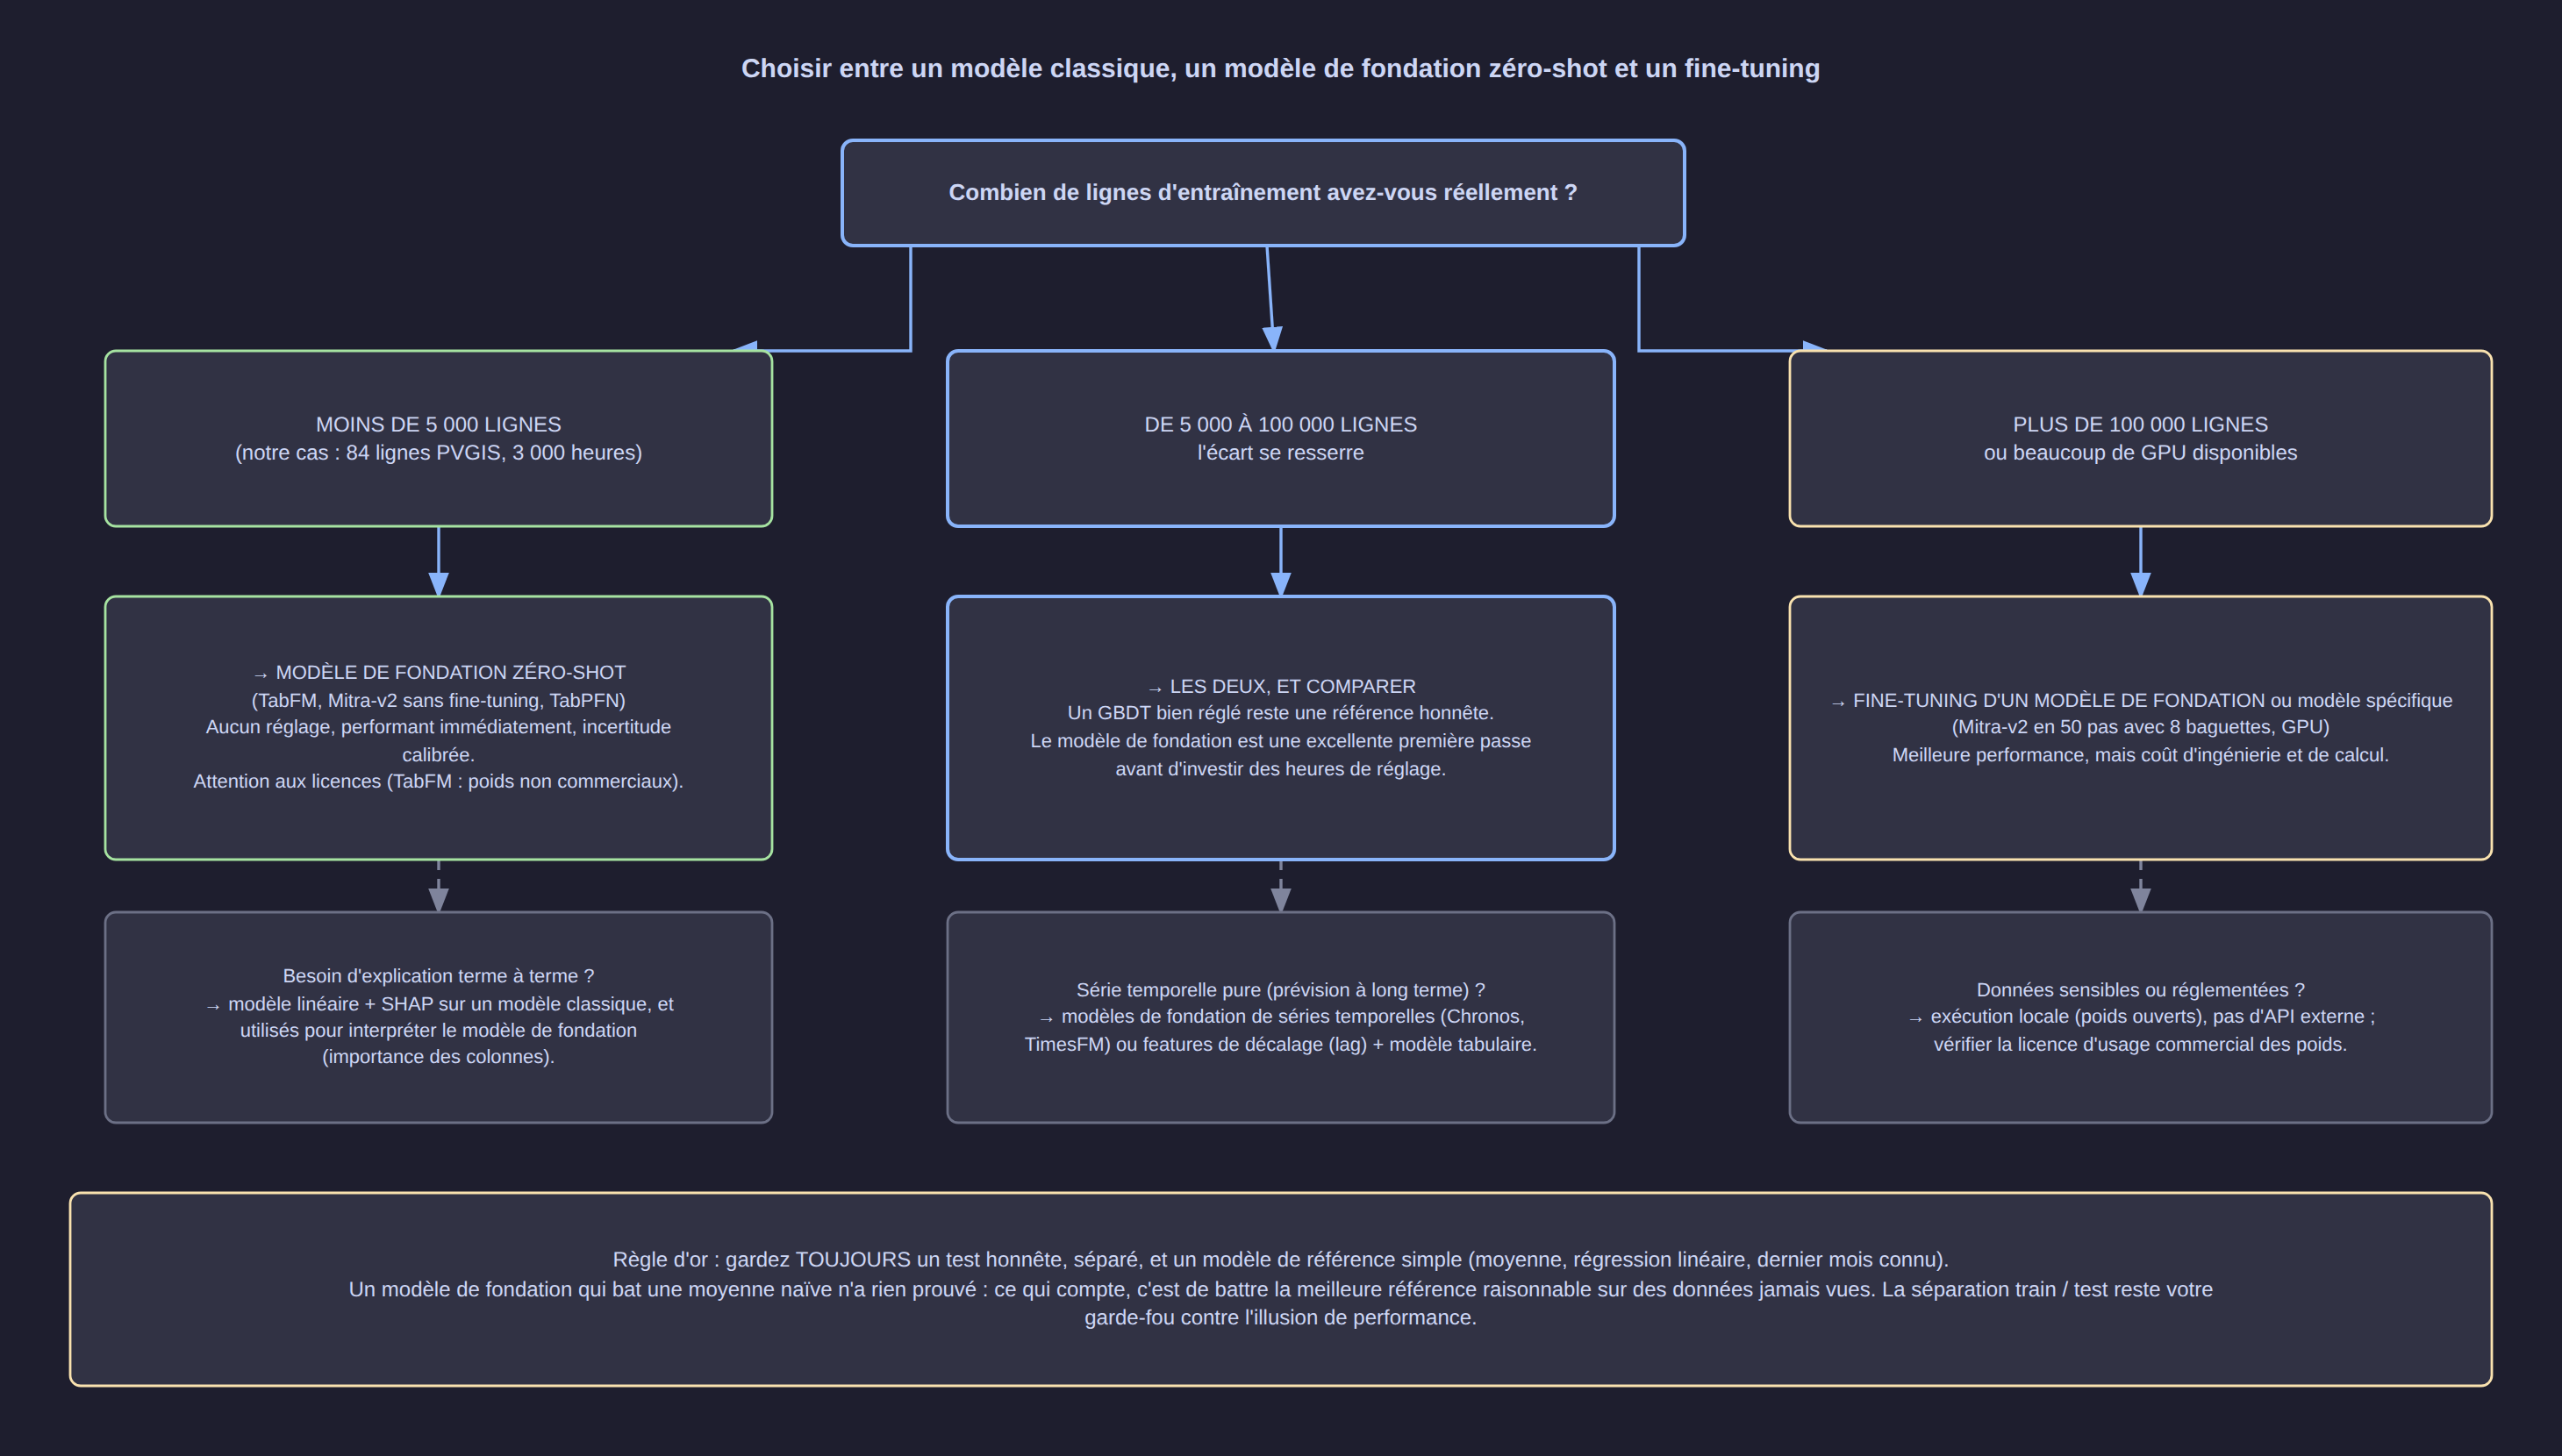
Trois précautions de lecture, valables pour toute comparaison de modèles :
- Un classement n'est pas une garantie pour votre problème. Les benchmarks agrègent des dizaines de tâches : la moyenne peut être excellente et votre cas particulier mauvais.
- L'écart entre les trois premiers se mesure en points. Choisir entre TabFM, Mitra-v2 et TabPFN-3 sur un classement revient souvent à choisir sur la licence, le coût d'exécution et l'écosystème (ici : AutoGluon, très outillé, et Apache-2.0).
- Toujours comparer à une référence simple — moyenne, régression linéaire, arbre boosté — sur vos données, avec votre découpage entraînement/test.
5. Le cas d'usage : prévoir le solaire d'une maison à Badoudou (Sokone)
Le jeu de données est décrit en détail dans l'article compagnon ; l'essentiel :
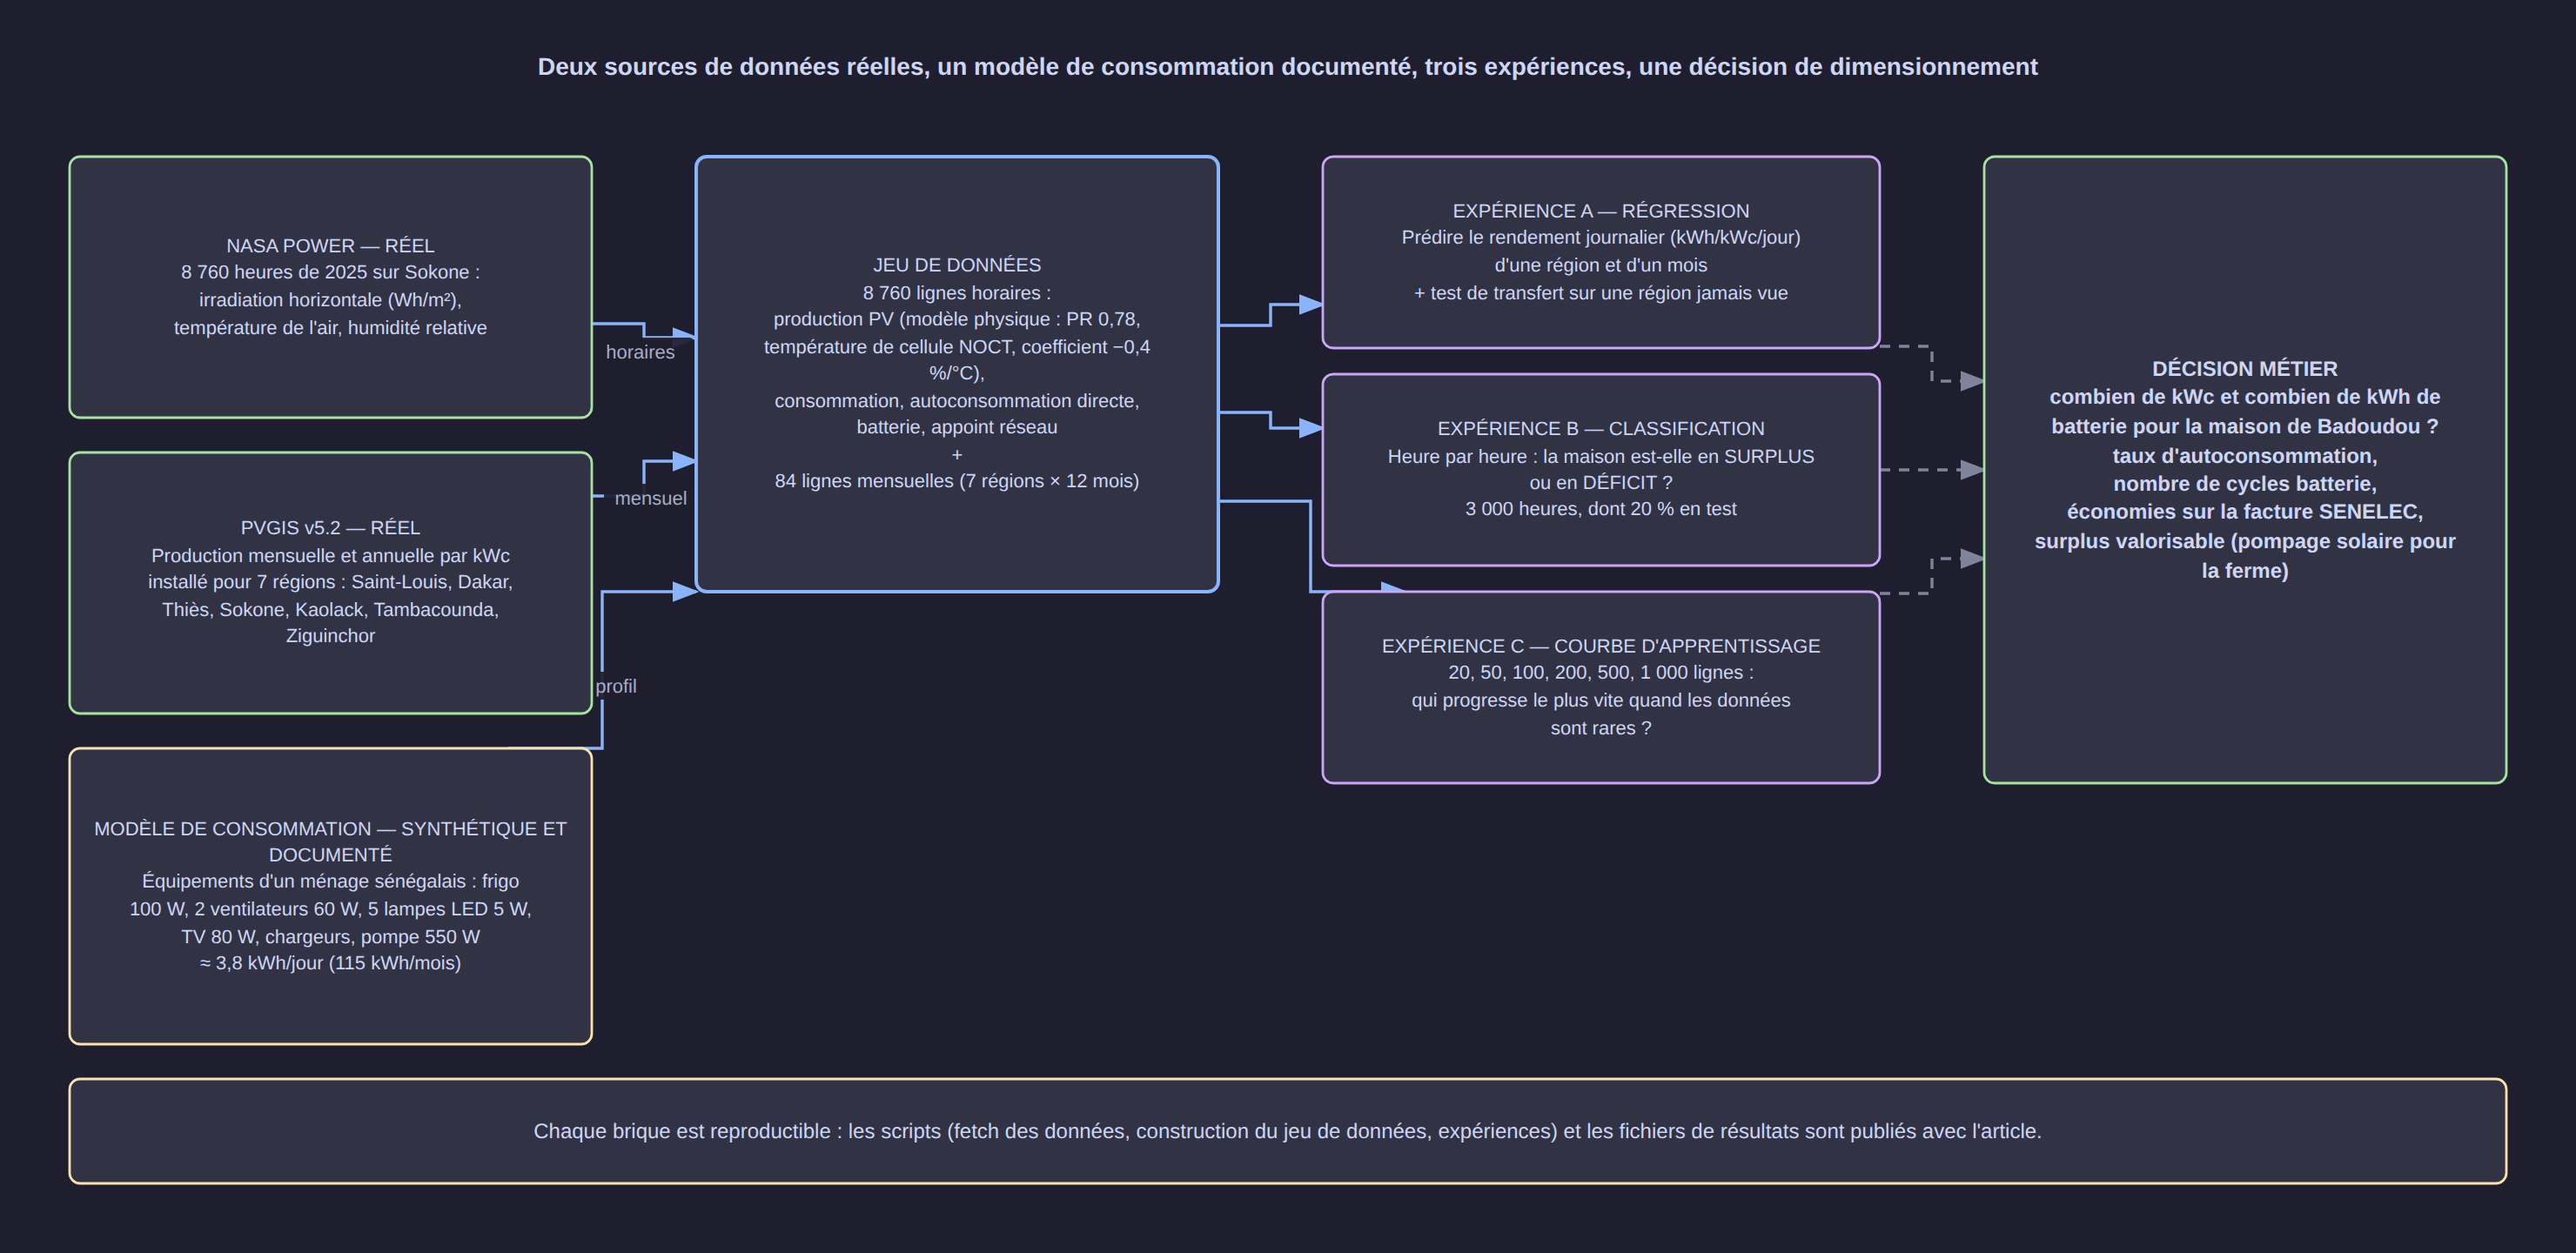
- Production photovoltaïque : données réelles. NASA POWER fournit 8 760 heures (2025) d' irradiation, de température et d'humidité pour Sokone ; PVGIS donne le rendement mensuel par kWc de 7 régions du Sénégal. La production horaire est calculée par un modèle physique (ratio de performance 0,78, dé-rating thermique −0,4 %/°C).
- Consommation : modèle d'équipements documenté. Réfrigérateur, ventilateurs, éclairage, TV, chargeurs, pompe : ≈ 3,8 kWh/jour, soit 1 378 kWh par an.
- Question : 1,5 kWc + 5 kWh de batterie suffisent-ils, et que reste-t-il à acheter au réseau ?
La simulation horaire complète donne :
| Configuration | Autoconsommation | Achat réseau | Surplus annuel |
|---|---|---|---|
| 1,5 kWc, sans batterie | 41,3 % | 809 kWh/an | 1 579 kWh/an |
| 1,5 kWc + batterie 5 kWh | 97,0 % | 1 kWh/an | 728 kWh/an |
| 3,0 kWc + batterie 5 kWh | 97,3 % | 0,5 kWh/an | 2 880 kWh/an |
Avec les tarifs SENELEC de janvier 2026 (82 FCFA/kWh pour les 150 premiers kWh mensuels), couvrir 1 378 kWh/an représente environ 113 000 FCFA d'achat évité par an — le détail des hypothèses et le calcul complet sont dans l'article TabFM, section 6.6.
Où Mitra-v2 apporte quelque chose de spécifique ici : la prédiction de production est une régression, et dimensionner une installation sur un mauvais jour est le vrai enjeu. Une prévision ponctuelle ne dit pas grand-chose ; une distribution (quantiles bas, médiane, haut) dit combien de jours par an la batterie sera vide. C'est précisément ce que la tête à 1 000 intervalles fournit, et ce qu'un simple arbre boosté ne donne pas sans travail supplémentaire (régression quantile, bootstrap, conformal prediction).
6. Faut-il fine-tuner ? Le calcul honnête
Fine-tunez si :
- vous disposez de plusieurs milliers de lignes et d'un GPU ;
- votre domaine est particulier (capteurs spécifiques, unités métier, saisonnalités locales) ;
- vous avez besoin de la meilleure précision possible et d'une distribution bien calibrée ;
- vous pouvez répéter l'opération à chaque mise à jour des données (industrialisation).
Ne fine-tunez pas si :
- vous avez quelques dizaines ou quelques centaines de lignes : le zéro-shot fait déjà le travail, et 50 pas de fine-tuning sur 84 lignes risquent surtout d'apprendre du bruit ;
- vous n'avez pas de GPU disponible : l'inférence zéro-shot tourne sur CPU ;
- votre problème est instable dans le temps (le modèle spécialisé devra être refait souvent) ;
- vous cherchez d'abord une réponse rapide : le zéro-shot donne 80 % du résultat en 20 % du temps.
Dans tous les cas, la démarche gagnante est une échelle : référence naïve → modèle classique → modèle de fondation zéro-shot → fine-tuning. On ne monte d'un cran que si le cran précédent ne suffit pas.
7. Limites et pièges
- Tout est synthétique. Mitra-v2 n'a jamais vu de données réelles à l'entraînement : les domaines très éloignés des priors restent fragiles. La fiche du modèle invite explicitement à évaluer sur des données de validation représentatives avant tout usage.
- Fine-tuning = risque de surapprentissage quand les données sont rares — d'où les 8 copies baguées de la recette officielle, qu'il ne faut pas « simplifier ».
- Ce n'est pas un outil de causalité. Le modèle prédit très bien une variable à partir d'autres ; il ne dit pas pourquoi, ni ce qui se passerait si l'on changeait une entrée.
- Erreur classique : juger sur la moyenne. Avec une tête distributionnelle, on peut être excellent en probabilité et moyen sur la valeur moyenne. Choisissez la métrique qui correspond à la décision (coût d'un jour sans batterie, pas RMSE).
- Le coût caché, c'est l'industrialisation : versionner le modèle et le contexte d'entraînement, surveiller la dérive des données, et documenter ce qui a été fine-tuné et quand.
8. À retenir
- Mitra-v2 est un modèle de fondation tabulaire de 77 M de paramètres, pré-entraîné uniquement sur des priors synthétiques mixtes, conçu pour être fine-tuné : il atteint le niveau des meilleurs modèles de sa catégorie avec une fraction de leur taille.
- Il traite la régression comme une classification sur 1 000 intervalles : vous obtenez une distribution, donc de l'incertitude — précieux pour dimensionner une installation solaire.
- Tout est publié sous Apache-2.0 (poids, inférence, fine-tuning, évaluations), ce qui lève la question de licence qui complique l'usage commercial de certains poids concurrents.
- Sur le cas sénégalais, l'essentiel du résultat ne vient pas du modèle mais du protocole : données réelles, modèle physique explicite, découpage de test honnête, référence naïve à battre.
Ressources
- Rapport technique : Mitra-v2 Technical Report (arXiv 2609.04540) ; article fondateur : Mitra — Mixed synthetic priors (arXiv 2510.21204)
- Recherche Amazon : Mitra — Mixed synthetic priors for enhancing tabular foundation models
- Poids et code : autogluon/mitra-regressor-2, autogluon/mitra-finetune
- Benchmarks cités : TabArena, TALENT (jeux de données réels de classification et de régression)
- Article compagnon : Google TabFM — Modèles de fondation tabulaires (prévision zéro-shot)