Les modèles supervisés — panorama, avantages, limites et cas d'usage
Last reviewed: 19 septembre 2026
XGBoost, régression linéaire, Random Forest, k-NN, SVM, réseau de neurones : quel modèle choisir, et pourquoi ? Cet article passe en revue les familles de modèles supervisés les plus utilisées en projet réel, explique pour chacune comment elle décide, ce qu'elle apporte, ce qu'elle coûte et dans quel cas elle est le bon outil. Tout est illustré, et un benchmark réel — 14 modèles, deux tâches, trois protocoles — chiffre les écarts sur des données de production solaire au Sénégal.
Article compagnon : Non supervisé, séries temporelles et détection d'anomalies (clustering, réduction de dimension, anomalies, prévision). Pour les modèles de fondation tabulaires — TabFM, Mitra-v2, TabPFN — voir les deux articles dédiés du dossier Data-Science.
1. Le vocabulaire minimum
| Terme | Ce que ça veut dire, concrètement |
|---|---|
| Variable (colonne, feature) | ce que le modèle a le droit de regarder : irradiation, température, mois, latitude |
| Cible (target) | ce qu'on veut prédire : une production, une probabilité de panne |
| Apprentissage | ajuster les paramètres du modèle pour réduire l'erreur sur les données d'entraînement |
| Généralisation | bien se comporter sur des données jamais vues — le seul objectif qui compte |
| Métrique | la façon de mesurer l'erreur : MAE, RMSE, R², exactitude, rappel, F1… |
| Jeu de test | la portion de données mise de côté et regardée une seule fois, à la fin |
L'erreur de débutant numéro un est de confondre les deux premières lignes du tableau : un modèle peut être excellent sur les données d'entraînement et mauvais en production. Tout le reste de cet article découle de cette distinction.
2. La référence obligatoire : le modèle le plus bête possible
Avant tout algorithme, on construit une référence : prédire la moyenne (régression) ou la classe majoritaire (classification). Dans notre benchmark, la moyenne naïve donne :
| Protocole | Erreur moyenne (MAE) | R² |
|---|---|---|
| Découpage aléatoire | 0,2405 kWh/kWc/jour | −0,08 |
| Région inconnue laissée de côté | 0,3661 kWh/kWc/jour | −0,17 |
Un R² négatif signifie que la référence fait pire que prédire la moyenne globale. C'est exactement l'intérêt de cette ligne : elle donne l'échelle. Un modèle qui l'améliore à peine ne mérite pas un projet ; un modèle qui l'améliore de 60 % (voir §7) raconte quelque chose du phénomène.
3. Les quatre grandes familles
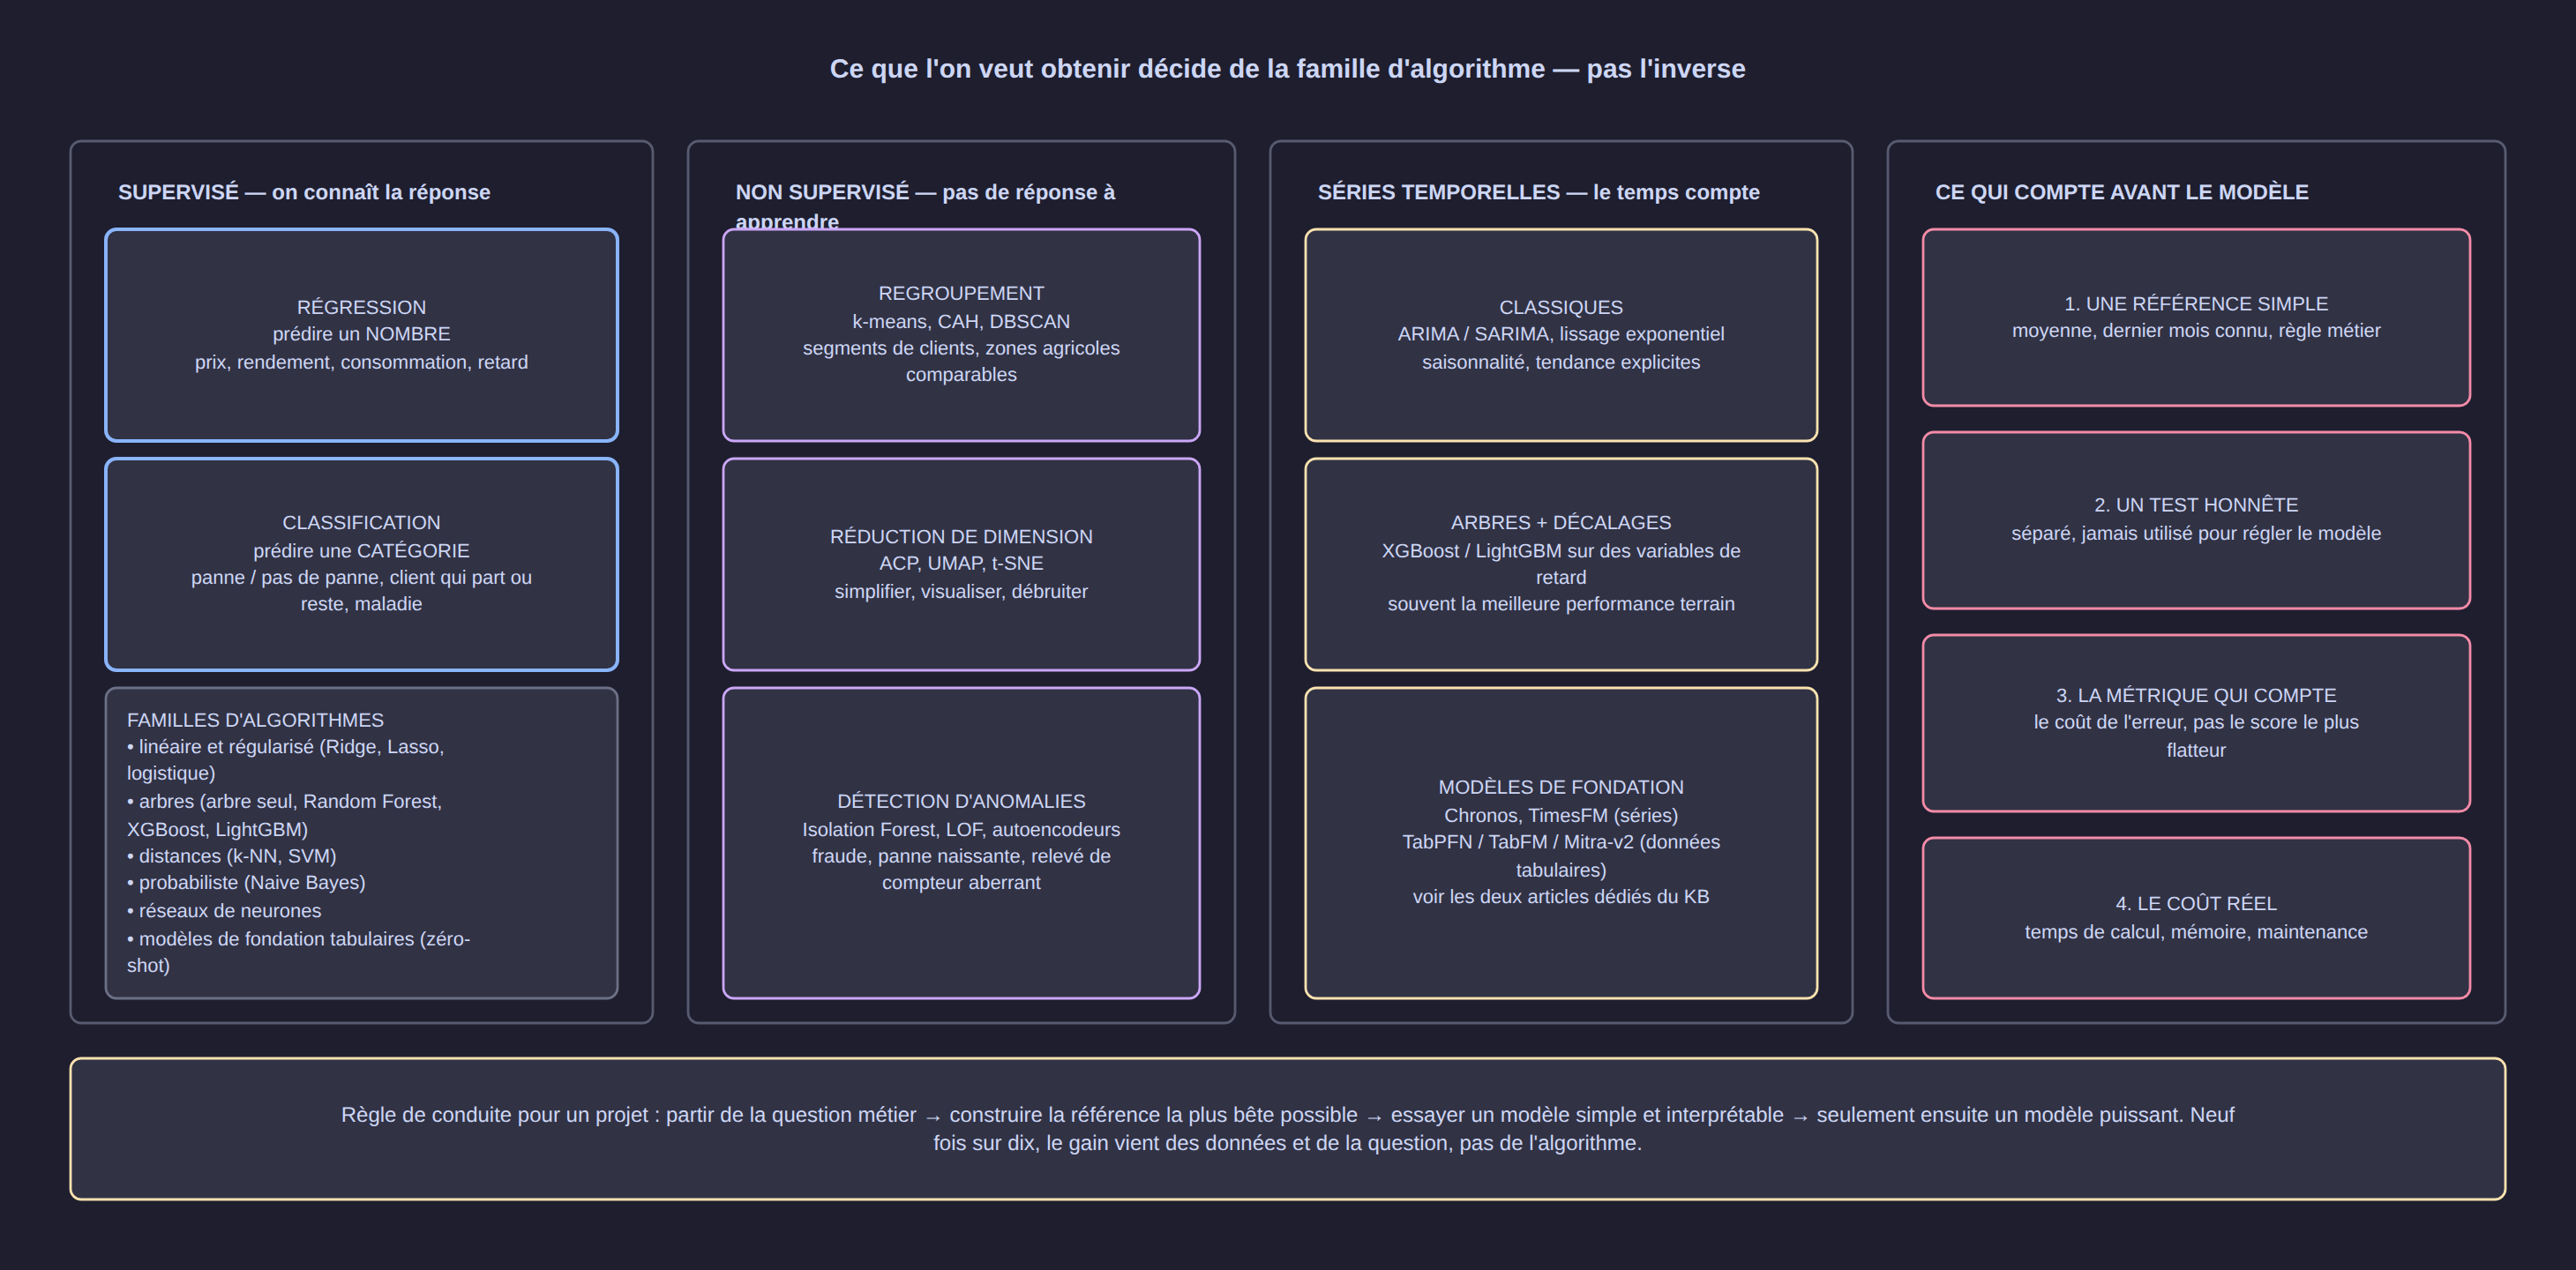
La question métier décide de la famille, jamais l'inverse :
- Supervisé — on connaît la réponse dans les données historiques. Deux sous-cas : prédire un nombre (régression) ou une catégorie (classification).
- Non supervisé — aucune réponse à apprendre : on cherche une structure (groupes, résumé, anomalie).
- Séries temporelles — la variable dépend du temps, et l'ordre des lignes porte de l'information.
- Modèles de fondation — entraînés une fois pour toutes sur des millions de tâches ; ils contournent une partie du travail de mise au point (articles dédiés).
4. Comment lire la fiche d'un modèle
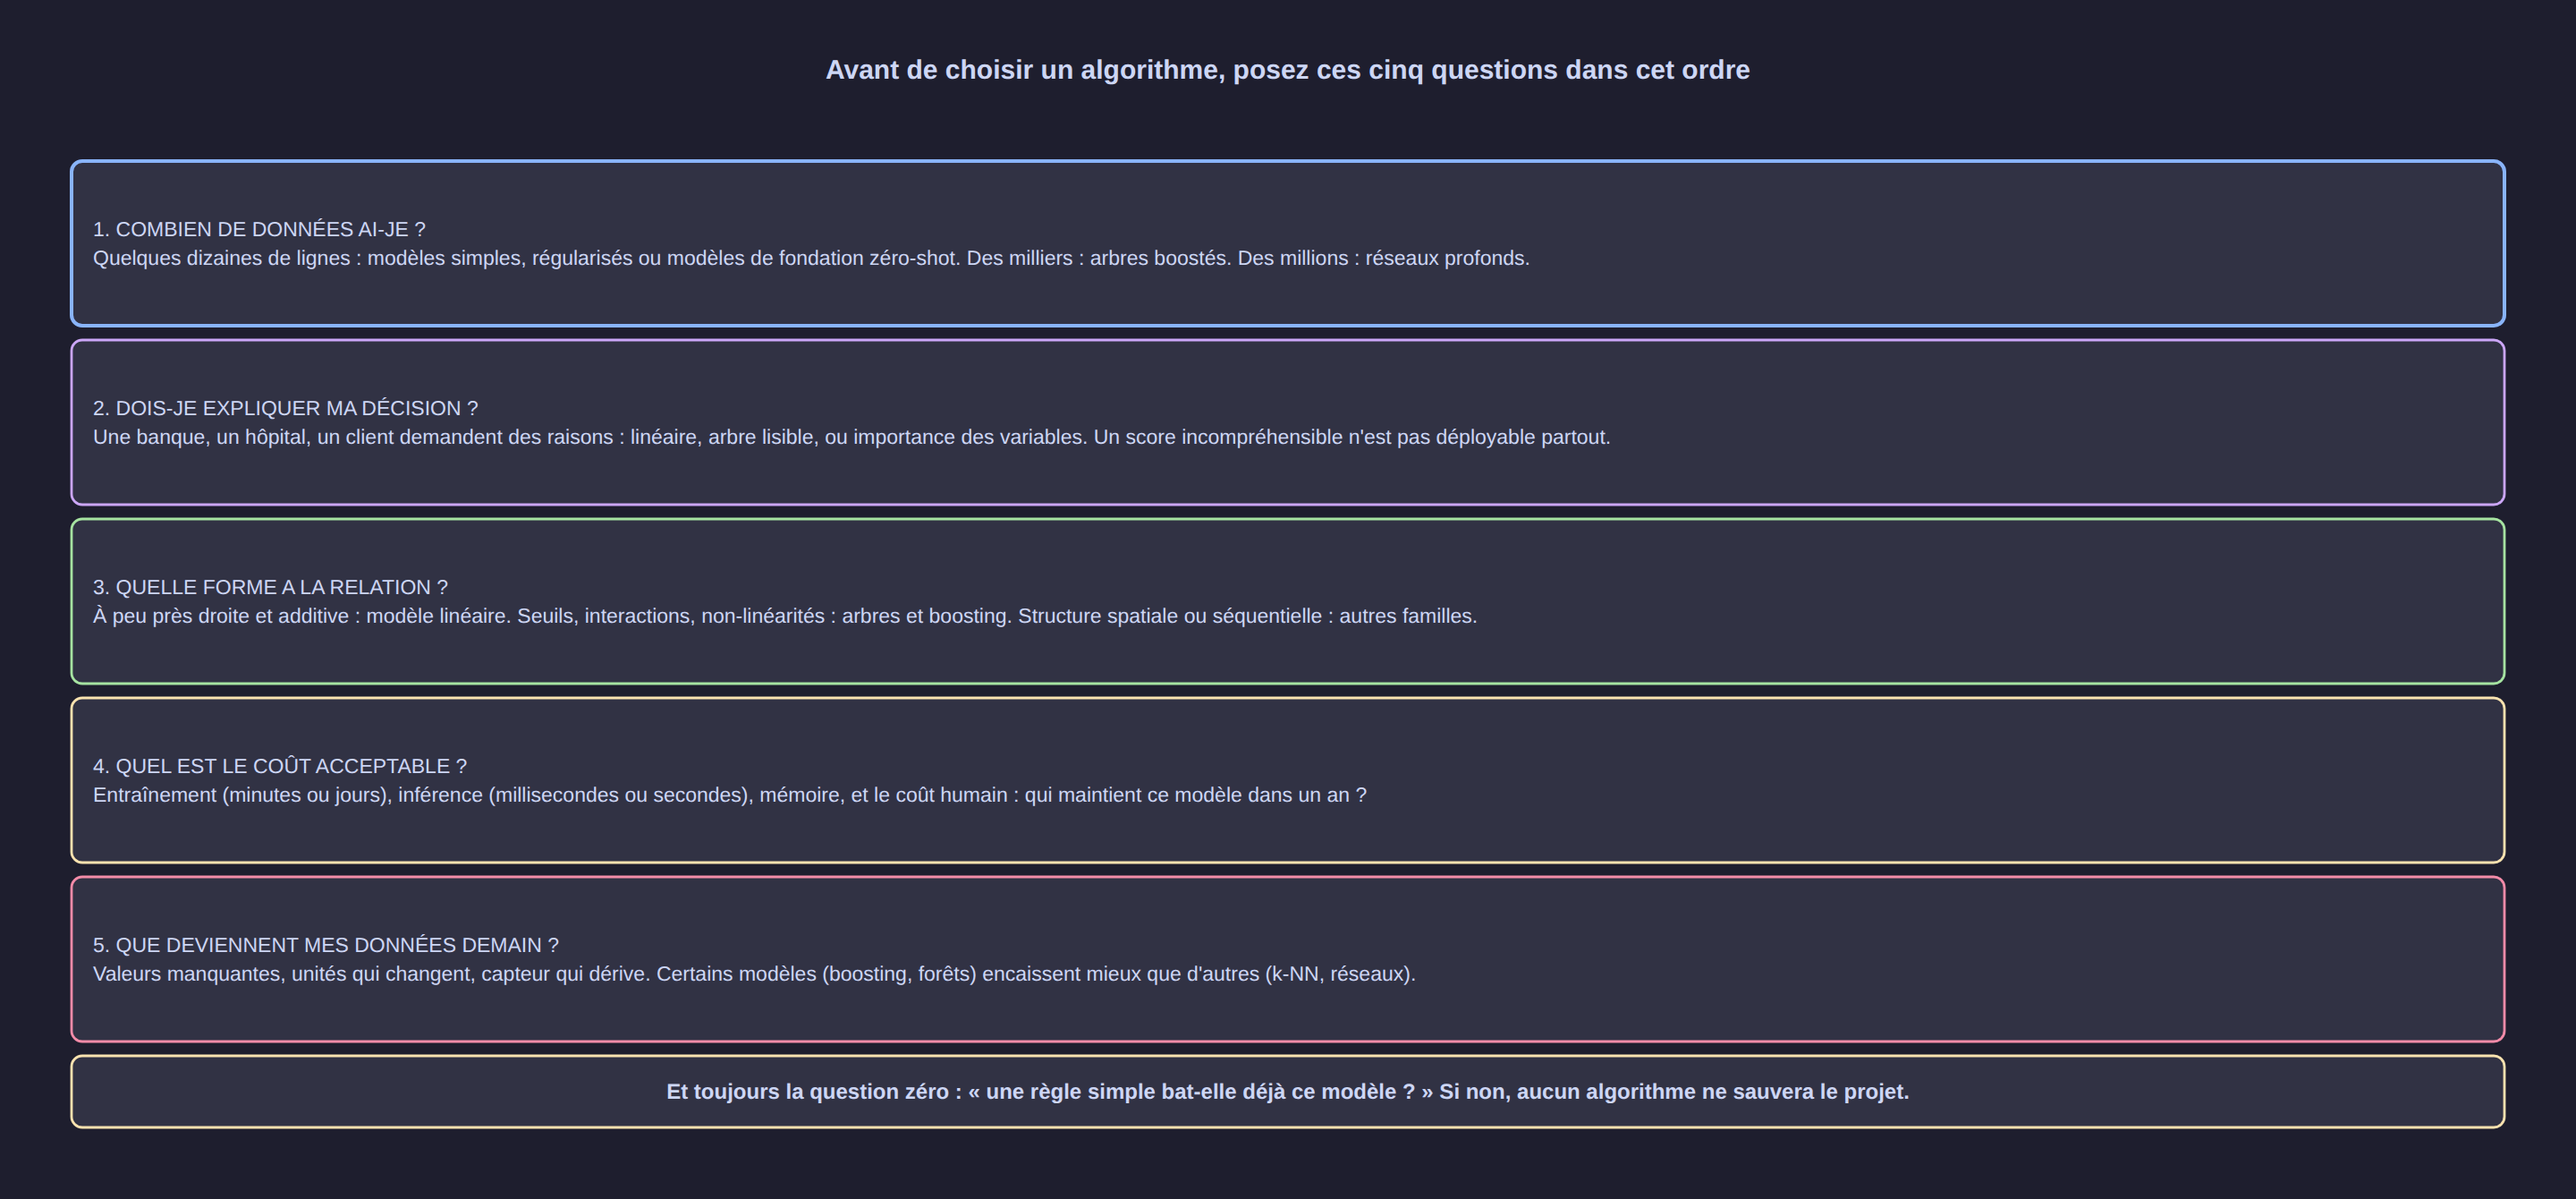
Cinq questions, dans cet ordre : combien de données ? faut-il expliquer la décision ? quelle forme a la relation ? quel coût est acceptable ? que deviennent les données demain ? Un modèle se choisit sur ces cinq réponses, pas sur un classement de blog.
5. Le compromis biais / variance, ou pourquoi « plus complexe » n'est pas « meilleur »
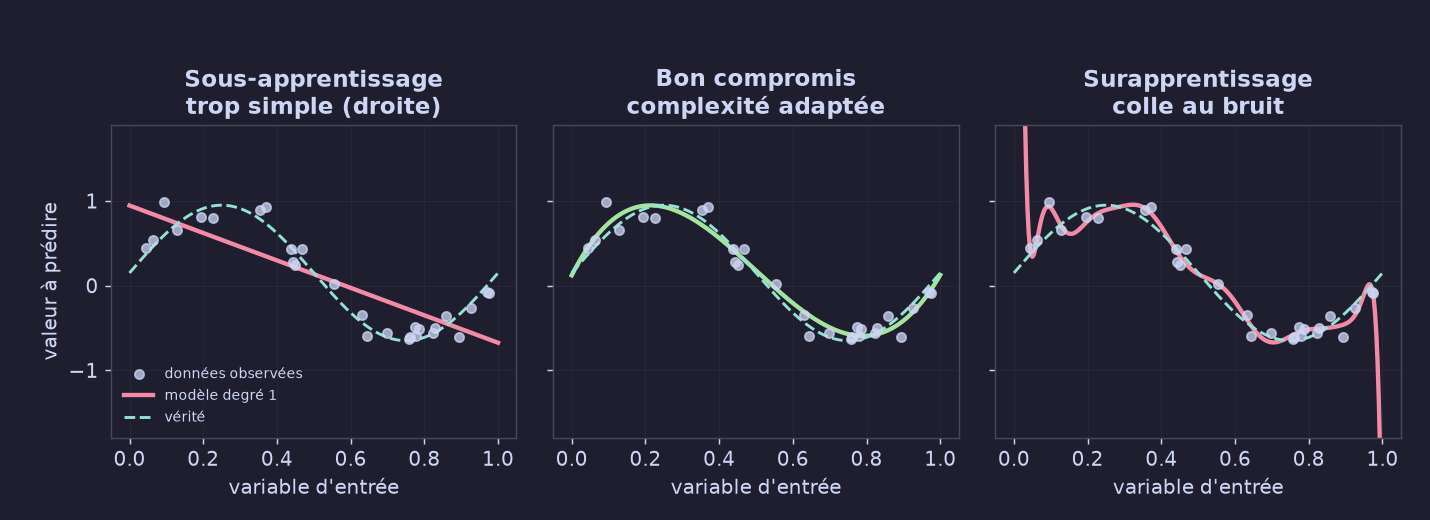
Trois modèles, les mêmes données :
- Sous-apprentissage (droite) : le modèle est trop simple pour représenter la réalité — erreur élevée partout.
- Bon compromis : la complexité correspond à la quantité d'information réellement disponible.
- Surapprentissage : le modèle épouse le bruit. Il devient parfait sur les données vues et catastrophique ailleurs.
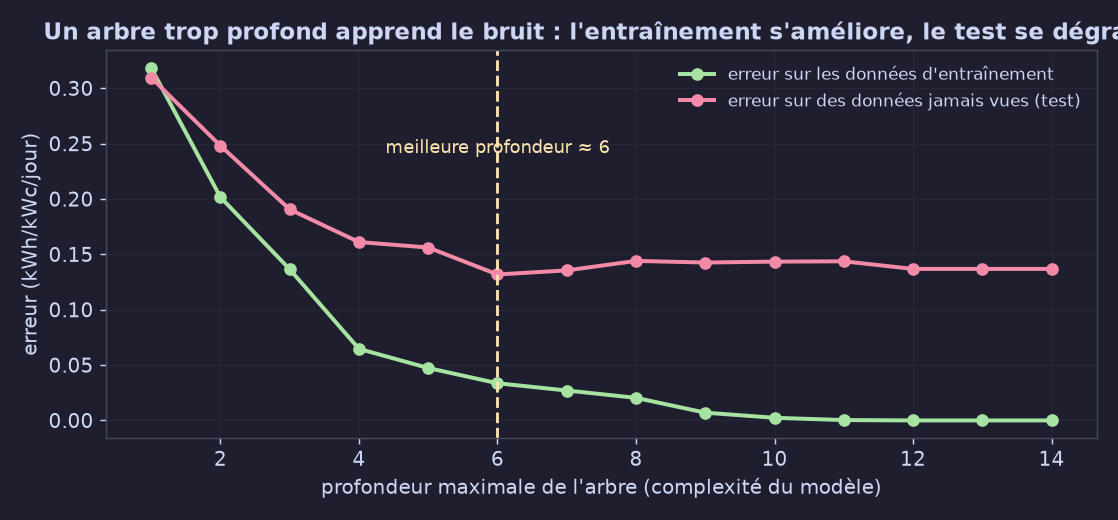
La figure ci-dessus est calculée sur nos données réelles : plus l'arbre est profond, meilleure est l'erreur d'entraînement, et pire devient l'erreur de test à partir d'un certain point. C'est le phénomène central de tout projet de machine learning.
6. Les modèles, un par un
6.1 Régression linéaire — la droite qui minimise les écarts
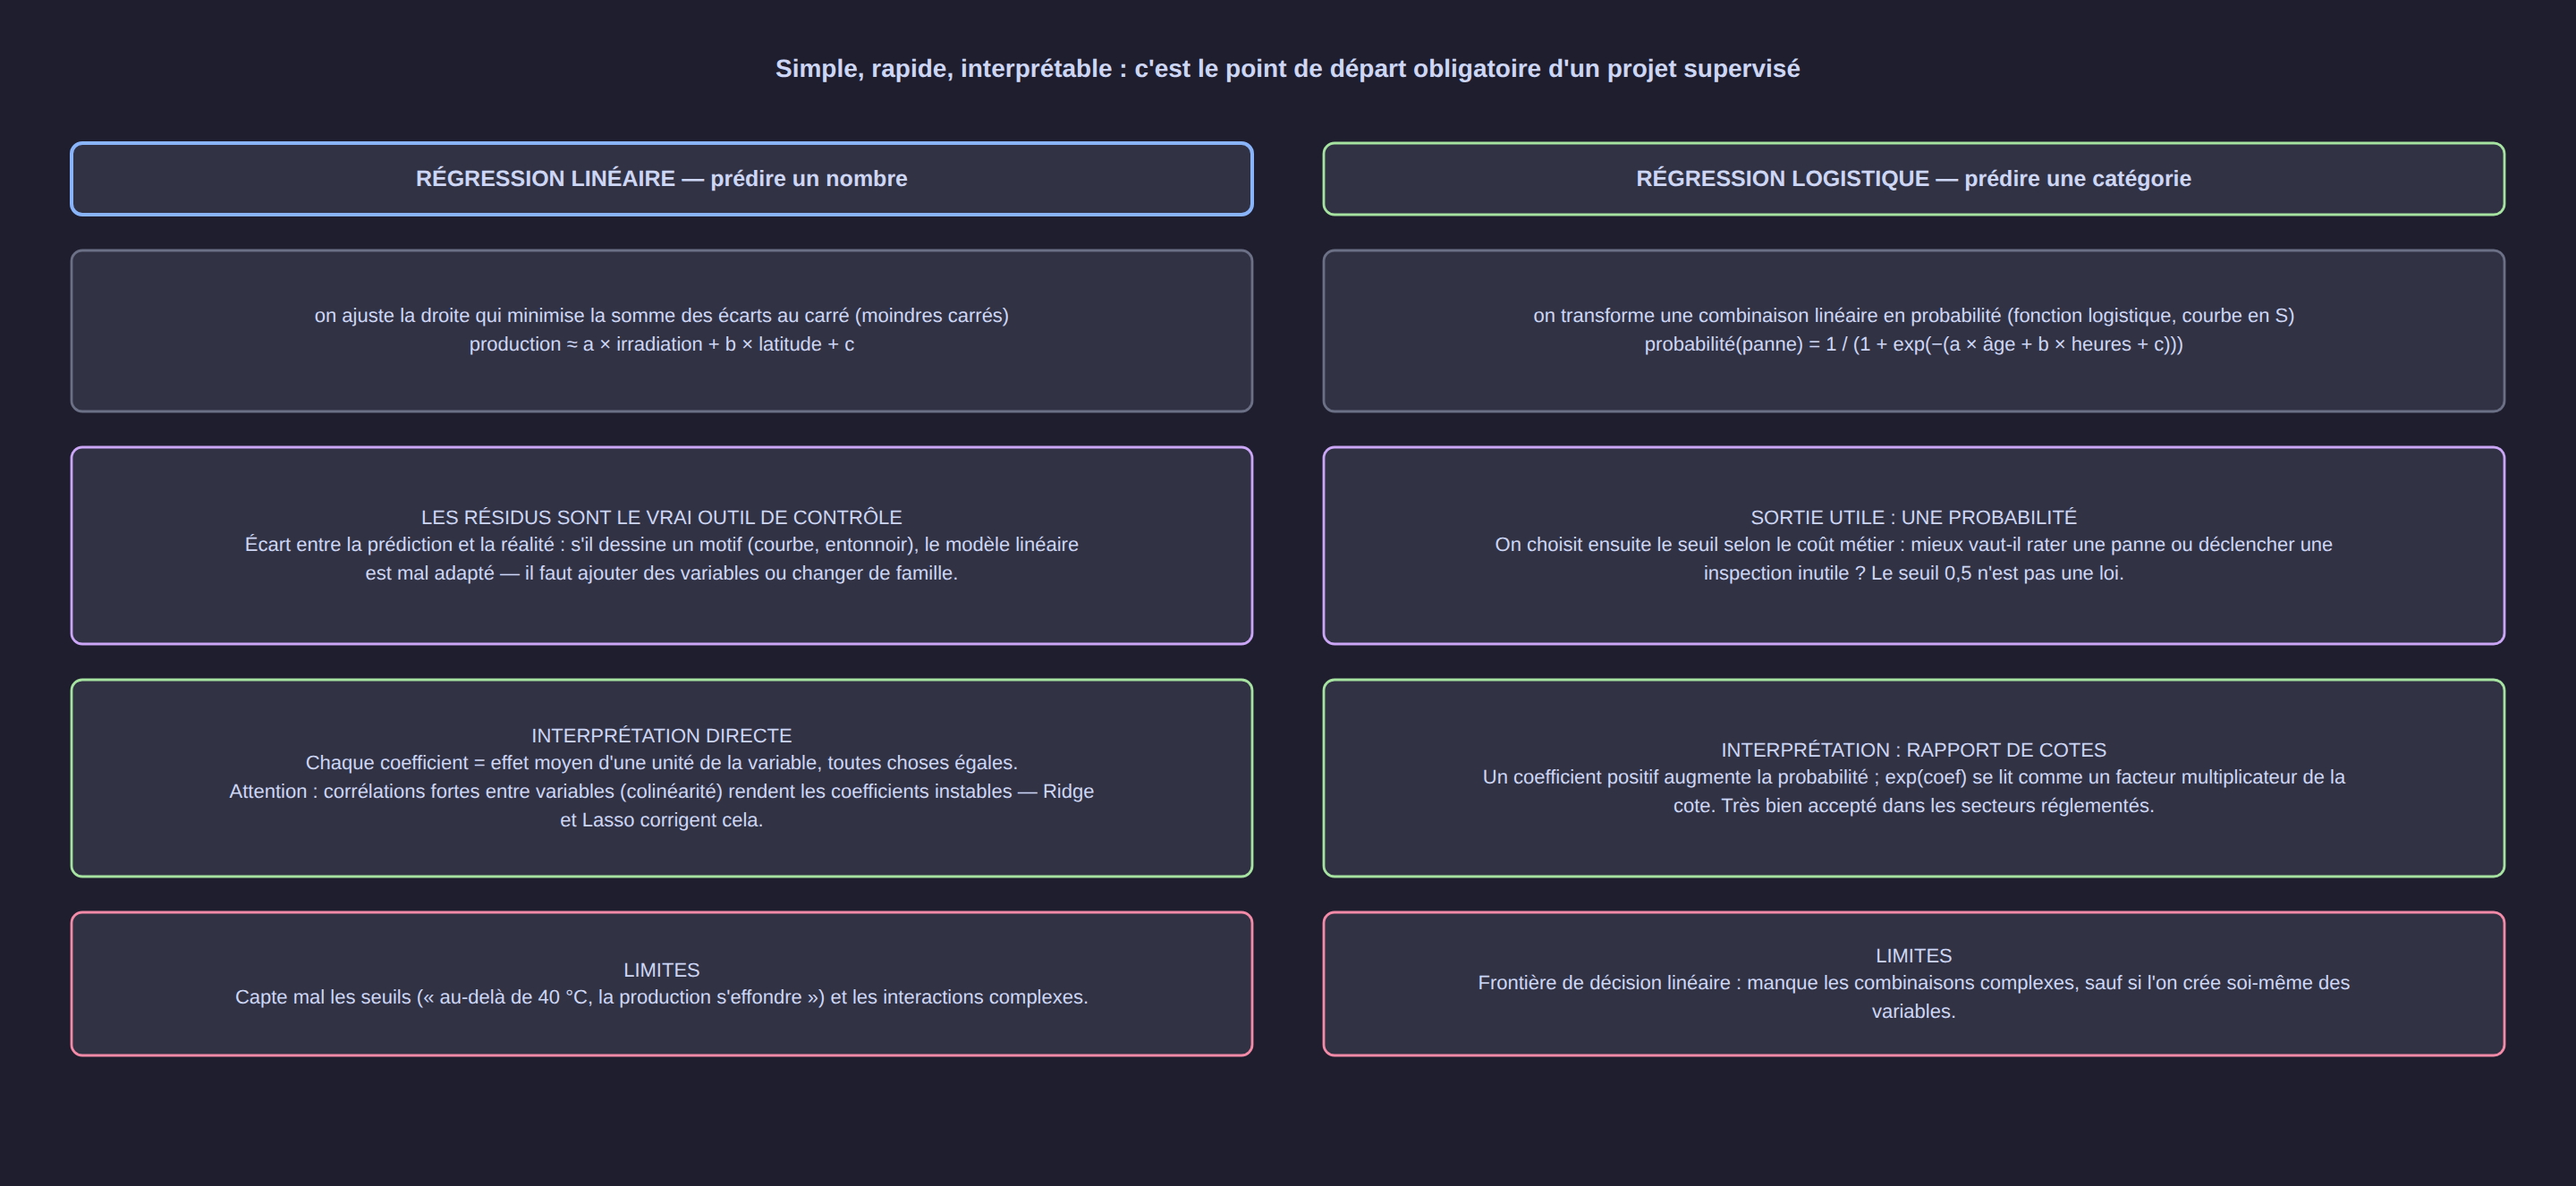
- L'idée en une phrase : la cible est une combinaison linéaire des variables
(
production ≈ a × irradiation + b × latitude + c). - Comment il décide : il choisit les coefficients qui minimisent la somme des carrés des écarts (méthode des moindres carrés). Les résidus (écarts entre prédiction et réalité) sont l'outil de contrôle : s'ils dessinent un motif, le modèle est mal adapté.
- Forces : instantané (millisecondes), interprétable (un coefficient = un effet moyen), fonctionne avec très peu de lignes, extrêmement bien compris dans les secteurs réglementés.
- Limites : ne capte pas les seuils ni les interactions complexes ; sensible aux valeurs aberrantes ; instable si deux variables sont très corrélées.
- Cas d'usage typiques : estimation de prix, effet d'un paramètre technique, premier modèle d'un projet, calcul d'élasticité, modèle de référence à battre.
- Dans notre benchmark : MAE 0,1039 et R² 0,83 avec… 67 lignes d'entraînement. Une droite bien utilisée est déjà un modèle sérieux.
from sklearn.linear_model import LinearRegression
m = LinearRegression().fit(X_train, y_train)
print(dict(zip(features, m.coef_.round(3))), m.intercept_)   # lisible immédiatement
6.2 Ridge, Lasso, Elastic Net — les mêmes, en mieux encadrés
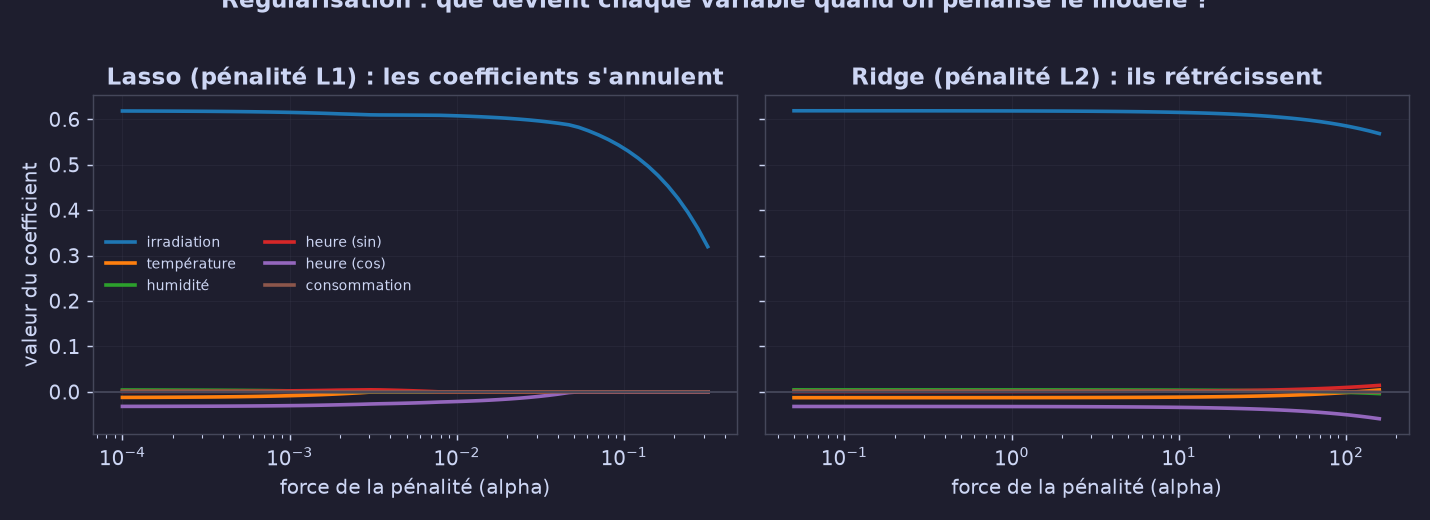
- L'idée : ajouter une pénalité pour empêcher les coefficients de devenir énormes ou de s'entredétruire quand les variables sont corrélées.
- Ridge (L2) rétrécit tous les coefficients ; Lasso (L1) en met certains exactement à zéro — donc il sélectionne les variables ; Elastic Net mélange les deux.
- Forces : plus stables que l'OLS, résistent mieux au bruit, Lasso produit un modèle plus court et donc plus explicable.
- Limites : il faut standardiser les variables (sinon la pénalité frappe selon les unités) ; le choix de la force de pénalité se fait par validation croisée.
- Cas d'usage : beaucoup de variables corrélées (capteurs redondants, relevés météo multiples), besoin d'un modèle court et défendable.
- Dans notre benchmark : Lasso fait légèrement mieux que l'OLS (MAE 0,1035 contre 0,1039), et nettement mieux quand une région entière est inconnue (0,1373 contre 0,1412).
6.3 Régression logistique — une probabilité, pas une étiquette
- L'idée : transformer une combinaison linéaire en probabilité avec une courbe en S.
- Comment il décide : on choisit ensuite un seuil (qui n'est pas obligatoirement 0,5) selon le coût réel des erreurs : rater une panne coûte-t-il plus cher qu'une inspection inutile ?
- Forces : rapide, calibré, interprétable (rapports de cotes), excellent même avec peu de données ; c'est le standard en risque de crédit, en médecine et en marketing.
- Limites : frontière de décision linéaire ; les classes déséquilibrées demandent un ajustement explicite.
- Dans notre benchmark : 99,4 % d'exactitude en 7 millisecondes d'entraînement — et des dizaines de milliers de fois plus rapide à l'inférence que le modèle de fondation qui atteint 100 %.
6.4 k plus proches voisins (k-NN) — « dis-moi qui sont tes voisins »
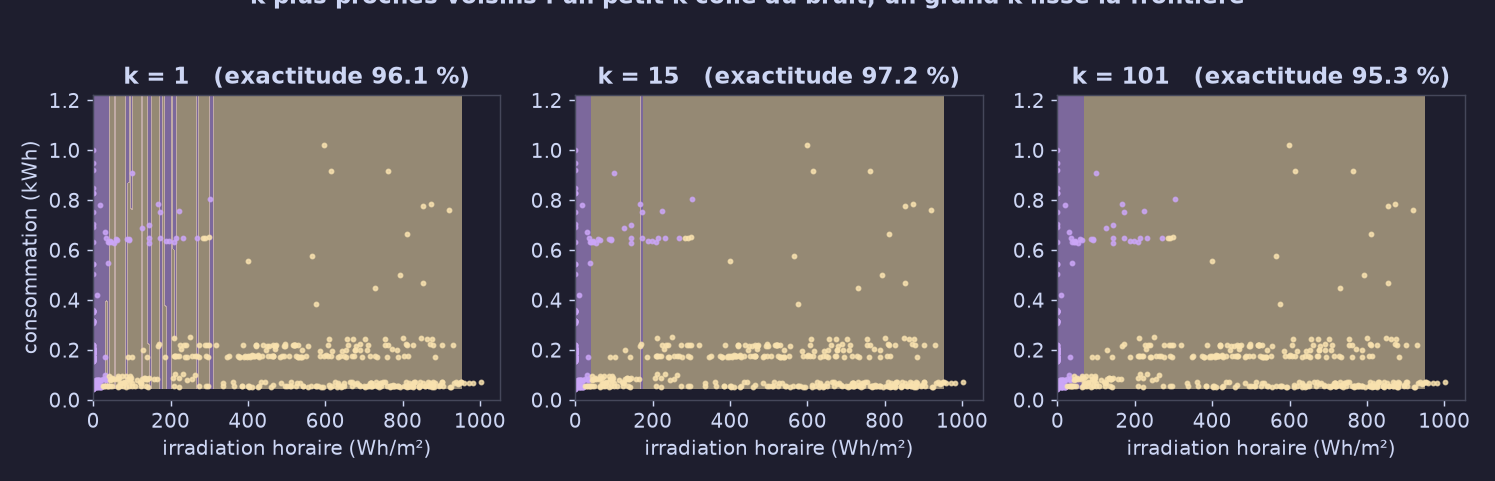
- L'idée : pour prédire un point, regarder ses
kvoisins les plus proches et voter (ou moyenner). Aucun entraînement : tout le coût est à la prédiction. - Le réglage qui compte :
k. Trop petit, le modèle suit le bruit ; trop grand, il lisse tout. La figure ci-dessus, calculée sur nos données réelles, montre les trois régimes. - Forces : concept immédiat, aucune hypothèse de forme, mise en œuvre triviale.
- Limites : souffre de la malédiction de la dimension (avec 20 variables, tout le monde est « loin »), exige une mise à l'échelle, sensible aux colonnes inutiles, lent en production.
- Cas d'usage : systèmes de recommandation simples, contrôle de similarité, étiquetage de proximité géographique.
- Dans notre benchmark : le pire des modèles classiques en régression (R² 0,56), moyen en classification (97,8 %) — l'un des rares cas où une méthode simple paie mal.
6.5 Arbre de décision — une suite de questions lisibles
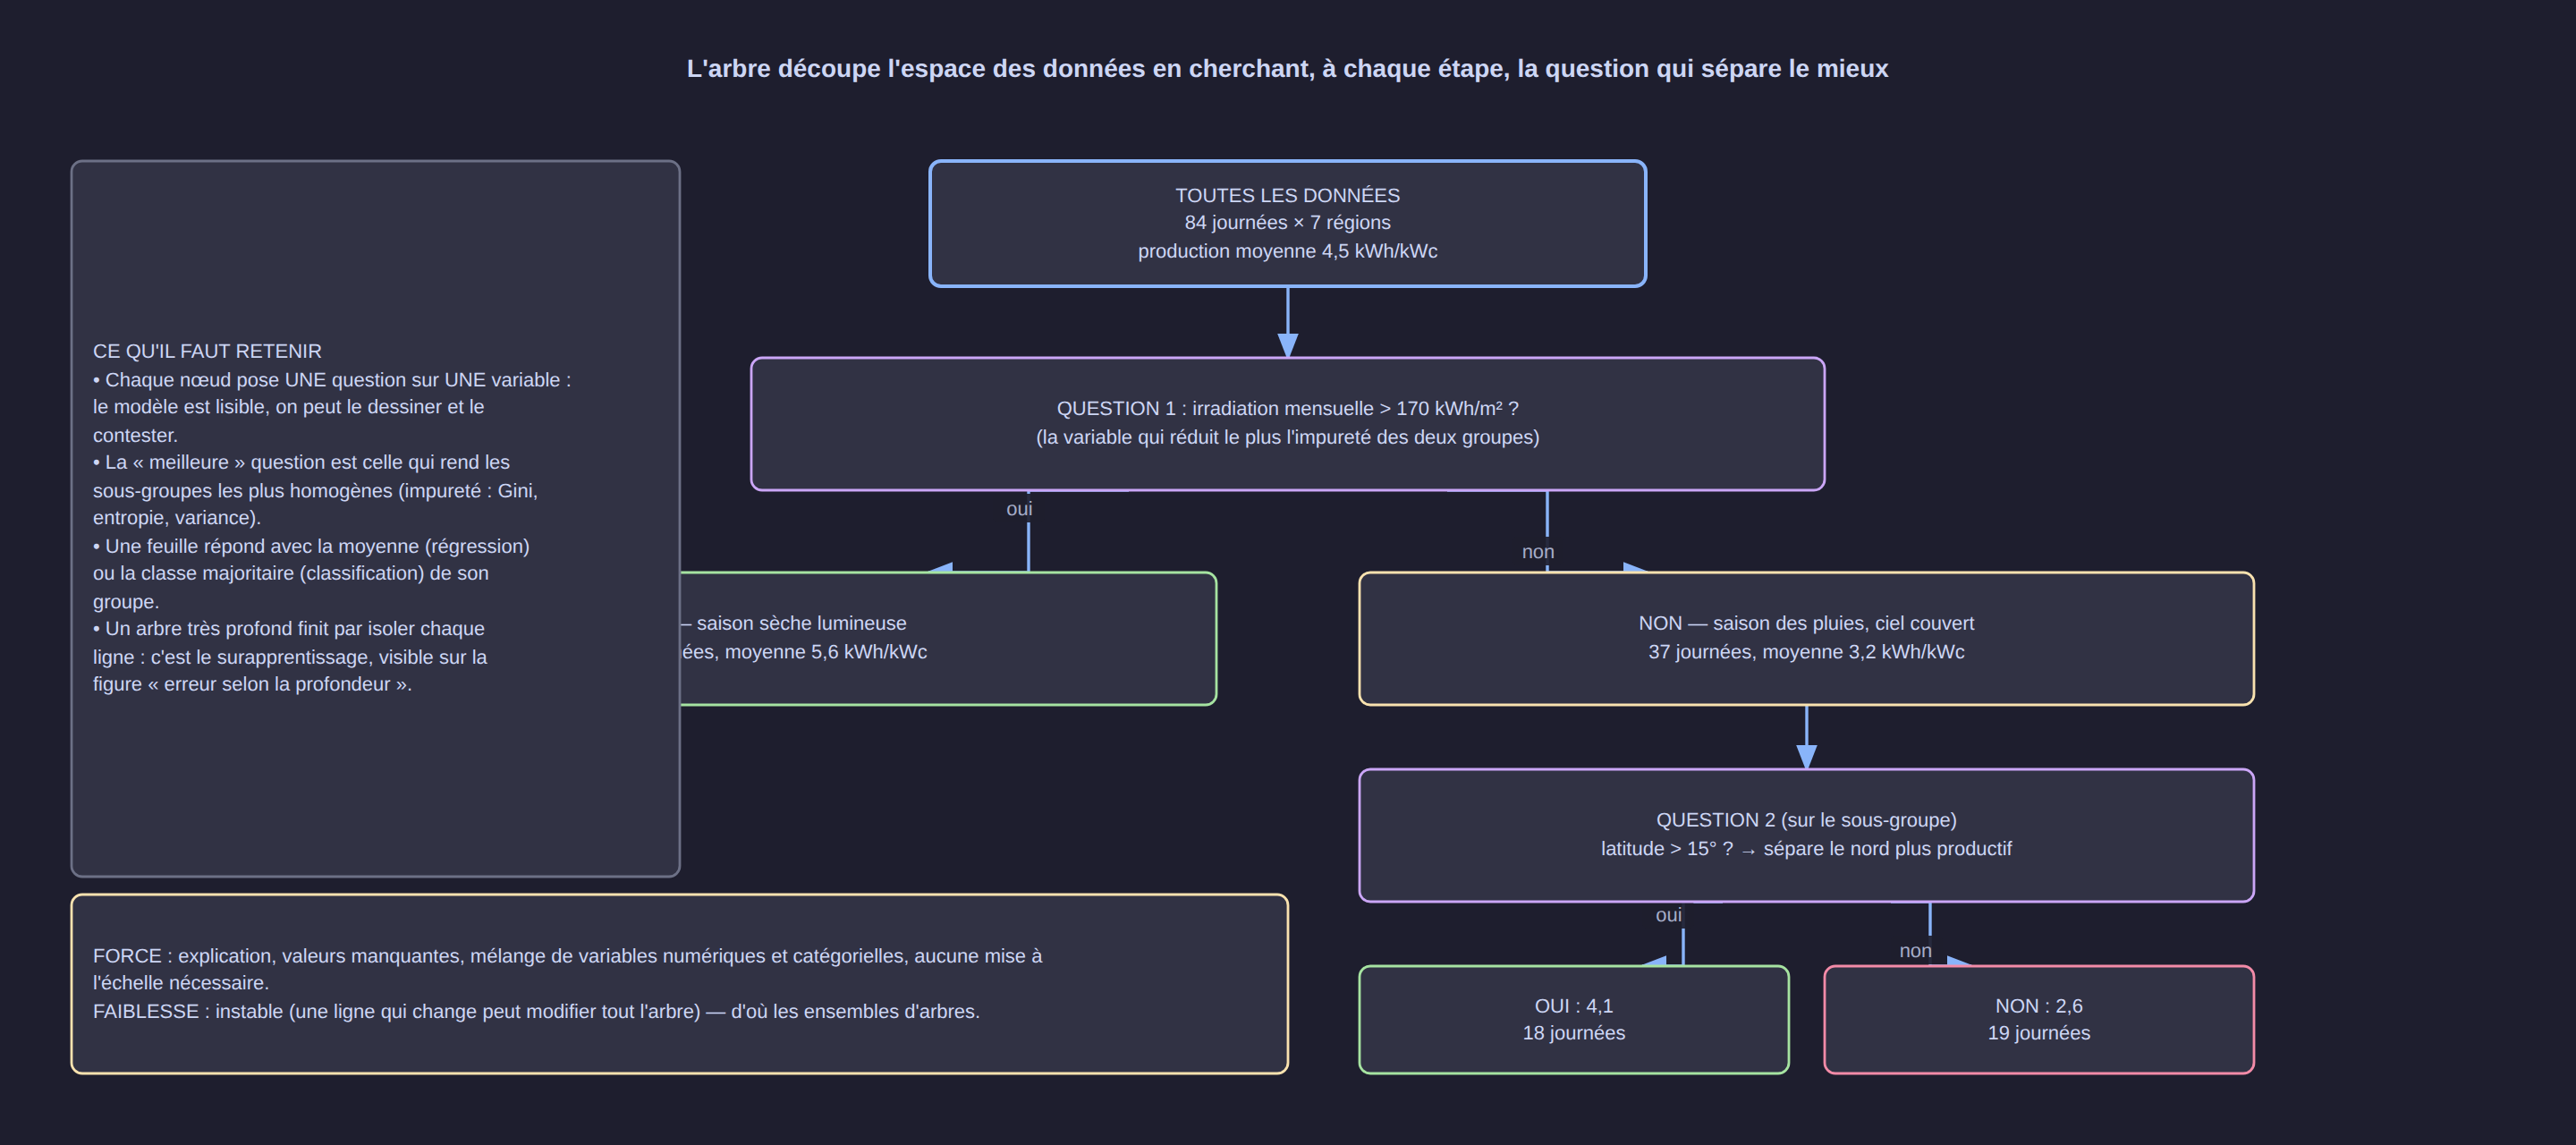
- L'idée : à chaque nœud, une question sur une variable, choisie pour séparer au mieux les données ; une feuille répond par la moyenne ou la classe majoritaire du groupe.
- Forces : explication en langage naturel, valeurs manquantes tolérées, mélange de variables numériques et catégorielles, aucune mise à l'échelle, interactions détectées automatiquement.
- Limites : très instable (changer une ligne peut changer tout l'arbre) et surapprend vite — d'où la figure « erreur selon la profondeur » ci-dessus, et d'où les ensembles d'arbres.
- Cas d'usage : règles de décision à valider par des experts, score de risque simple, base de discussion avec le métier.
- Dans notre benchmark : un arbre seul de profondeur 4 suffit à atteindre 99,8 % en classification — un excellent rapport lisibilité/performance.
6.6 Random Forest et Extra Trees — le vote de plusieurs arbres
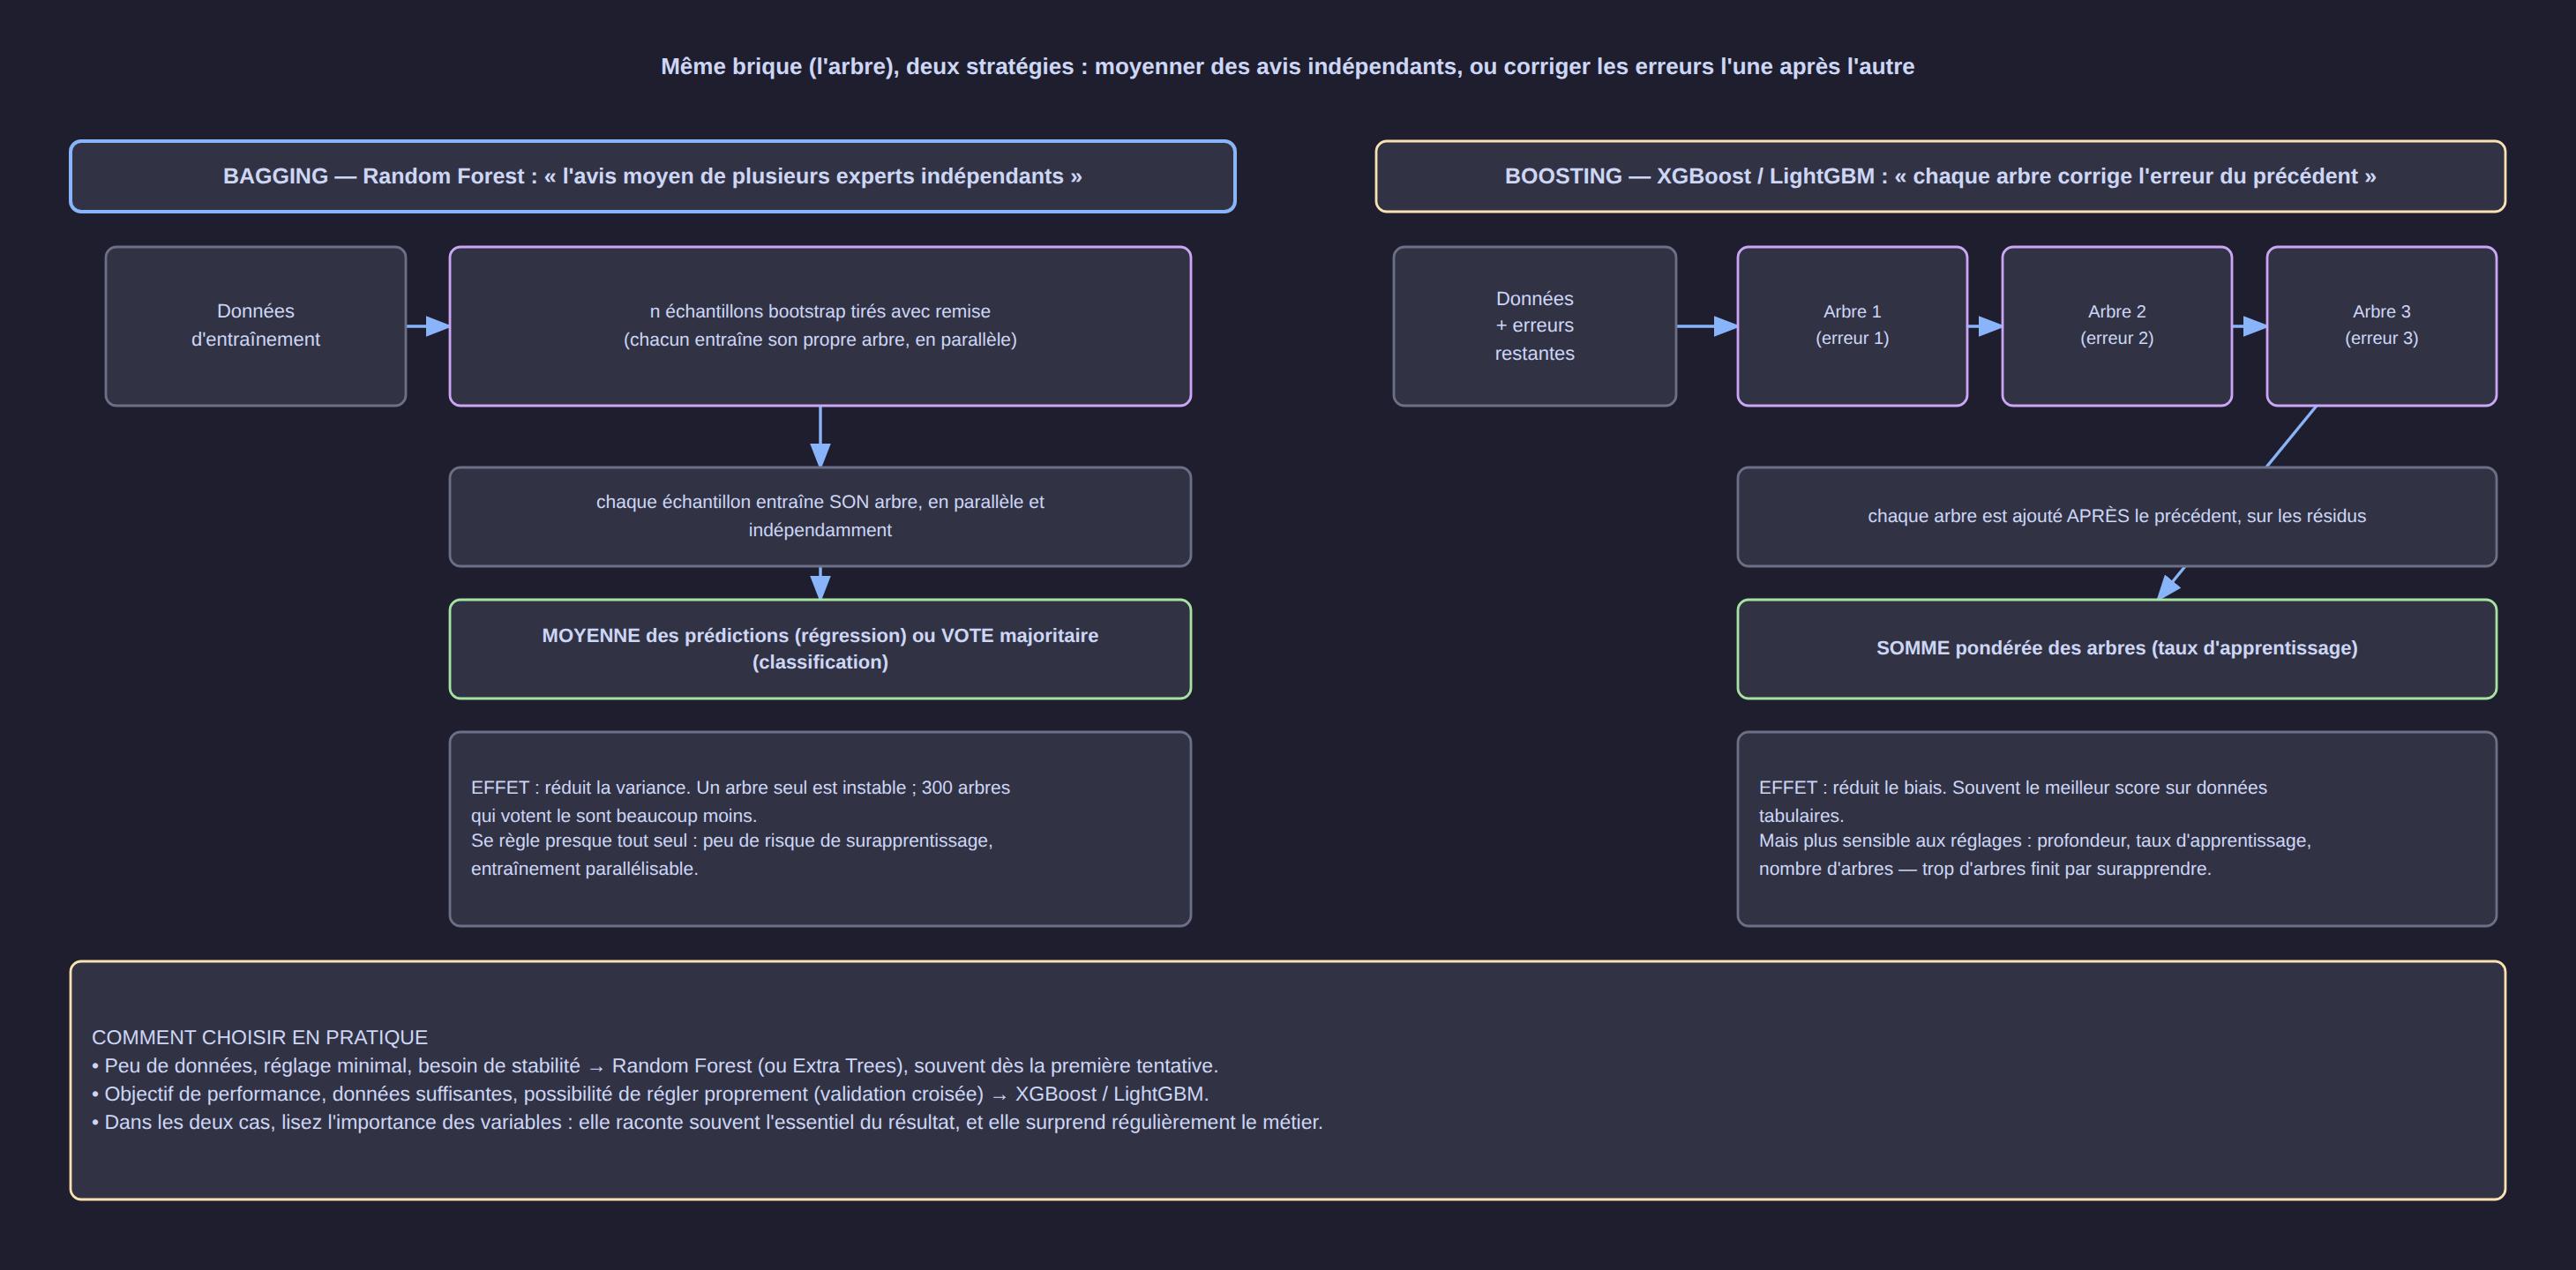
- L'idée (bagging) : entraîner des centaines d'arbres sur des échantillons tirés avec remise et des sous-ensembles de variables, puis moyenner leurs prédictions. Chaque arbre se trompe différemment ; la moyenne des erreurs s'annule en partie.
- Extra Trees : même principe, mais les seuils de coupure sont tirés au hasard — plus rapide, souvent aussi précis, un peu plus « lissé ».
- Une seule variable à régler sérieusement : le nombre d'arbres (300 suffit largement en pratique).
- Forces : très robuste, peu de réglage, parallélisable, donne une importance des variables, encaisse les valeurs aberrantes et manquantes.
- Limites : moins précis que le boosting sur beaucoup de tableaux ; modèle volumineux en mémoire ; peut être biaisé sur des classes très déséquilibrées.
- Cas d'usage : premier modèle « sérieux » d'un projet tabulaire, estimation d'importance des variables, données avec beaucoup de colonnes bruitées.
- Dans notre benchmark : MAE 0,0878 (R² 0,88) en découpage aléatoire ; 0,1023 (R² 0,90) en région inconnue — la meilleure famille « classique ».
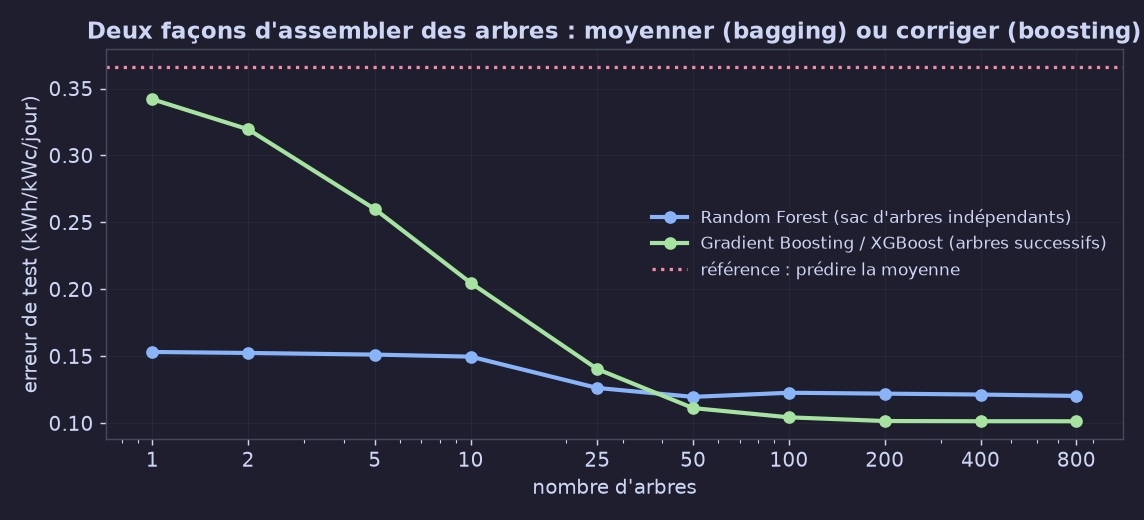
6.7 Gradient boosting : XGBoost, LightGBM, CatBoost
- L'idée (boosting) : construire des arbres les uns après les autres, chacun apprenant à corriger les erreurs restantes des précédents, puis sommer le tout avec un petit pas (taux d'apprentissage).
- Pourquoi ça marche si bien sur les tableaux : chaque arbre se concentre sur les exemples difficiles, ce qui réduit fortement le biais — et cela bat souvent les réseaux de neurones sur des données tabulaires de taille moyenne.
- Les trois variantes : XGBoost (le plus établi), LightGBM (le plus rapide sur gros volumes), CatBoost (le plus simple avec les variables catégorielles).
- Réglages qui comptent vraiment : nombre d'arbres, taux d'apprentissage (0,03–0,1), profondeur ou nombre de feuilles, et sous-échantillonnage. Trop d'arbres sans contrôle = surapprentissage.
- Limites : boîte noire relative (atténuée par SHAP), plus de réglage qu'un Random Forest, peut surapprendre sur des petits jeux de données bruités.
- Cas d'usage : compétitions, scoring, prévision de la demande, détection de fraude, tout projet où l'on cherche les derniers points de performance.
- Dans notre benchmark : XGBoost meilleur que Random Forest en découpage aléatoire (0,0844) mais moins bon quand une région entière est inconnue (0,1107 contre 0,1023) : le boosting exploite bien les régularités vues, un peu moins bien l'extrapolation.
6.8 SVM (machines à vecteurs de support)
- L'idée : trouver la frontière qui sépare les classes en maximisant la marge, avec un noyau pour gérer les frontières courbes.
- Forces : performant sur des données de taille moyenne avec beaucoup de variables (texte, spectres, images simples), base théorique solide, peu de surapprentissage avec une bonne marge.
- Limites : passe mal à l'échelle (complexité quadratique en nombre de lignes), réglage délicat (C, gamma), aucune interprétation directe, pas de probabilités natives.
- Cas d'usage : classification de textes courts, détection de signatures, petits jeux de données à forte dimension.
- Dans notre benchmark : 98,0 % en classification ; en revanche R² 0,48 quand une région est inconnue — fragile hors de son domaine d'entraînement.
6.9 Naive Bayes
- L'idée : appliquer le théorème de Bayes en supposant (à tort mais efficacement) que les variables sont indépendantes.
- Forces : très rapide, fonctionne avec peu de données, excellent pour le texte (filtres de spam, tri de documents), donne des probabilités.
- Limites : l'hypothèse d'indépendance est rarement vraie ; les probabilités sont mal calibrées.
- Dans notre benchmark : 96,2 % d'exactitude — le plus faible des modèles non triviaux, mais avec le temps d'entraînement le plus court (1 ms).
6.10 Réseaux de neurones (perceptron multicouche)
- L'idée : empiler des couches de transformations non linéaires pour apprendre des relations complexes.
- Forces : excellent sur les images, le texte et le son ; capte des interactions très complexes ; s'améliore avec les données et le calcul.
- Limites sur données tabulaires : demande beaucoup de données, beaucoup de réglages, ne donne aucune explication directe, et extrapole très mal hors du domaine vu à l'entraînement.
- Le contre-exemple de notre benchmark est spectaculaire : en découpage aléatoire le MLP atteint R² 0,34 ; quand une région entière est inconnue, il s'effondre à R² −18,3 (MAE 1,11 contre 0,14 pour une régression linéaire). Autrement dit : sur 84 lignes, un réseau de neurones n'a pas sa place — et le benchmark le prouve chiffres en main.
- Cas d'usage : dès qu'il y a beaucoup de données non structurées ; presque jamais comme premier choix sur un tableau de 100 à 10 000 lignes.
6.11 Modèles de fondation tabulaires (pour mémoire)
Pré-entraînés sur des millions de tables synthétiques, ils prédisent en apprentissage en contexte, sans entraînement ni réglage. Dans notre benchmark, TabPFN v2 zéro-shot est le meilleur des 14 modèles en régression (MAE 0,0362, R² 0,98) comme en extrapolation régionale (MAE 0,0858) — mais il est lent à l'inférence sur CPU (833 s pour 495 lignes) et son poids est à vérifier selon l'éditeur (licence, clé d'API). Détails complets dans les deux articles dédiés.
7. Le benchmark : 14 modèles, deux tâches, trois protocoles
Tout est reproductible (scripts fournis) et calculé sur les données du cas solaire de Badoudou : production photovoltaïque réelle (PVGIS, 7 régions, 12 mois) et consommation modélisée d'un ménage.
7.1 Régression — prédire la production journalière
Protocole 1 : découpage aléatoire (67 lignes d'entraînement, 17 de test).
| Modèle | MAE | R² | Entraînement |
|---|---|---|---|
| Moyenne naïve (référence) | 0,2405 | −0,08 | — |
| TabPFN v2 (zéro-shot) | 0,0362 | 0,98 | 0,41 s |
| XGBoost | 0,0844 | 0,85 | 0,12 s |
| Extra Trees | 0,0857 | 0,90 | 0,19 s |
| Random Forest | 0,0878 | 0,88 | 0,28 s |
| Lasso | 0,1035 | 0,84 | 0,004 s |
| Régression linéaire | 0,1039 | 0,83 | 0,009 s |
| Arbre de décision (profondeur 4) | 0,1053 | 0,79 | 0,004 s |
| Ridge | 0,1059 | 0,83 | 0,007 s |
| HistGradientBoosting | 0,1139 | 0,84 | 0,05 s |
| SVM (noyau RBF) | 0,1173 | 0,80 | 0,003 s |
| LightGBM | 0,1259 | 0,76 | 0,03 s |
| k plus proches voisins (k=5) | 0,1647 | 0,56 | 0,005 s |
| Réseau de neurones (MLP) | 0,2006 | 0,34 | 0,14 s |
Protocole 2 : une région entière laissée de côté (le test le plus dur ; moyenne sur 7 régions).
| Modèle | MAE moyenne | Pire région | R² |
|---|---|---|---|
| TabPFN v2 (zéro-shot) | 0,0858 | 0,190 | 0,93 |
| Extra Trees | 0,0962 | — | 0,92 |
| Random Forest | 0,1023 | 0,183 | 0,90 |
| XGBoost | 0,1107 | — | 0,88 |
| Arbre de décision | 0,1272 | — | 0,84 |
| Lasso | 0,1373 | — | 0,82 |
| Régression linéaire | 0,1412 | 0,234 | 0,81 |
| k plus proches voisins | 0,1593 | — | 0,79 |
| HistGradientBoosting | 0,1558 | — | 0,81 |
| LightGBM | 0,1650 | — | 0,79 |
| SVM (noyau RBF) | 0,2223 | — | 0,48 |
| Moyenne naïve | 0,3661 | — | −0,17 |
| Réseau de neurones (MLP) | 1,1098 | — | −18,3 |
7.2 Classification — surplus ou déficit, heure par heure
1 005 heures d'entraînement, 495 heures de test.
| Modèle | Exactitude | F1 | Entraînement | Prédiction (500 lignes) |
|---|---|---|---|---|
| Classe majoritaire (référence) | 55,6 % | 0,000 | — | — |
| LightGBM | 100,0 % | 1,000 | 0,07 s | 0,005 s |
| Arbre de décision (profondeur 4) | 99,80 % | 0,998 | 0,002 s | < 0,001 s |
| HistGradientBoosting | 99,80 % | 0,998 | 0,14 s | 0,008 s |
| XGBoost | 99,80 % | 0,998 | 0,06 s | 0,003 s |
| Random Forest | 99,60 % | 0,996 | 0,39 s | 0,120 s |
| Extra Trees | 99,39 % | 0,993 | 0,34 s | 0,131 s |
| Régression logistique | 99,39 % | 0,993 | 0,007 s | 0,003 s |
| Réseau de neurones (MLP) | 99,19 % | 0,991 | 0,53 s | 0,003 s |
| SVM (noyau RBF) | 97,98 % | 0,977 | 0,03 s | 0,008 s |
| k plus proches voisins | 97,78 % | 0,975 | 0,002 s | 0,011 s |
| Naive Bayes | 96,16 % | 0,956 | 0,001 s | 0,001 s |
| TabPFN v2 (zéro-shot) | 100,0 % | 1,000 | 0,19 s | 833 s |
7.3 Comment lire ce benchmark (cinq leçons)
- La référence d'abord. 55,6 % en classification et un R² négatif en régression : voilà ce qu'il faut battre. Tous les modèles sérieux le font largement.
- Le meilleur modèle dépend du protocole. XGBoost devance Random Forest en découpage aléatoire, l'inverse quand une région entière est inconnue. Un classement n'est jamais absolu.
- Peu de données change tout. Avec 84 lignes, les réseaux de neurones et les SVM décrochent ; les modèles régularisés et les forêts tiennent bon ; le modèle de fondation zéro-shot domine.
- Le coût compte. Le modèle le plus précis peut être des dizaines de milliers de fois plus lent à l'inférence. Sur une tâche quasi déterministe (tout le monde est entre 99 % et 100 %), la régression logistique est le choix rationnel.
- Un modèle simple bien compris bat souvent un modèle complexe mal réglé — et il se défend en réunion, ce qui n'est pas un détail.
8. Guide de choix
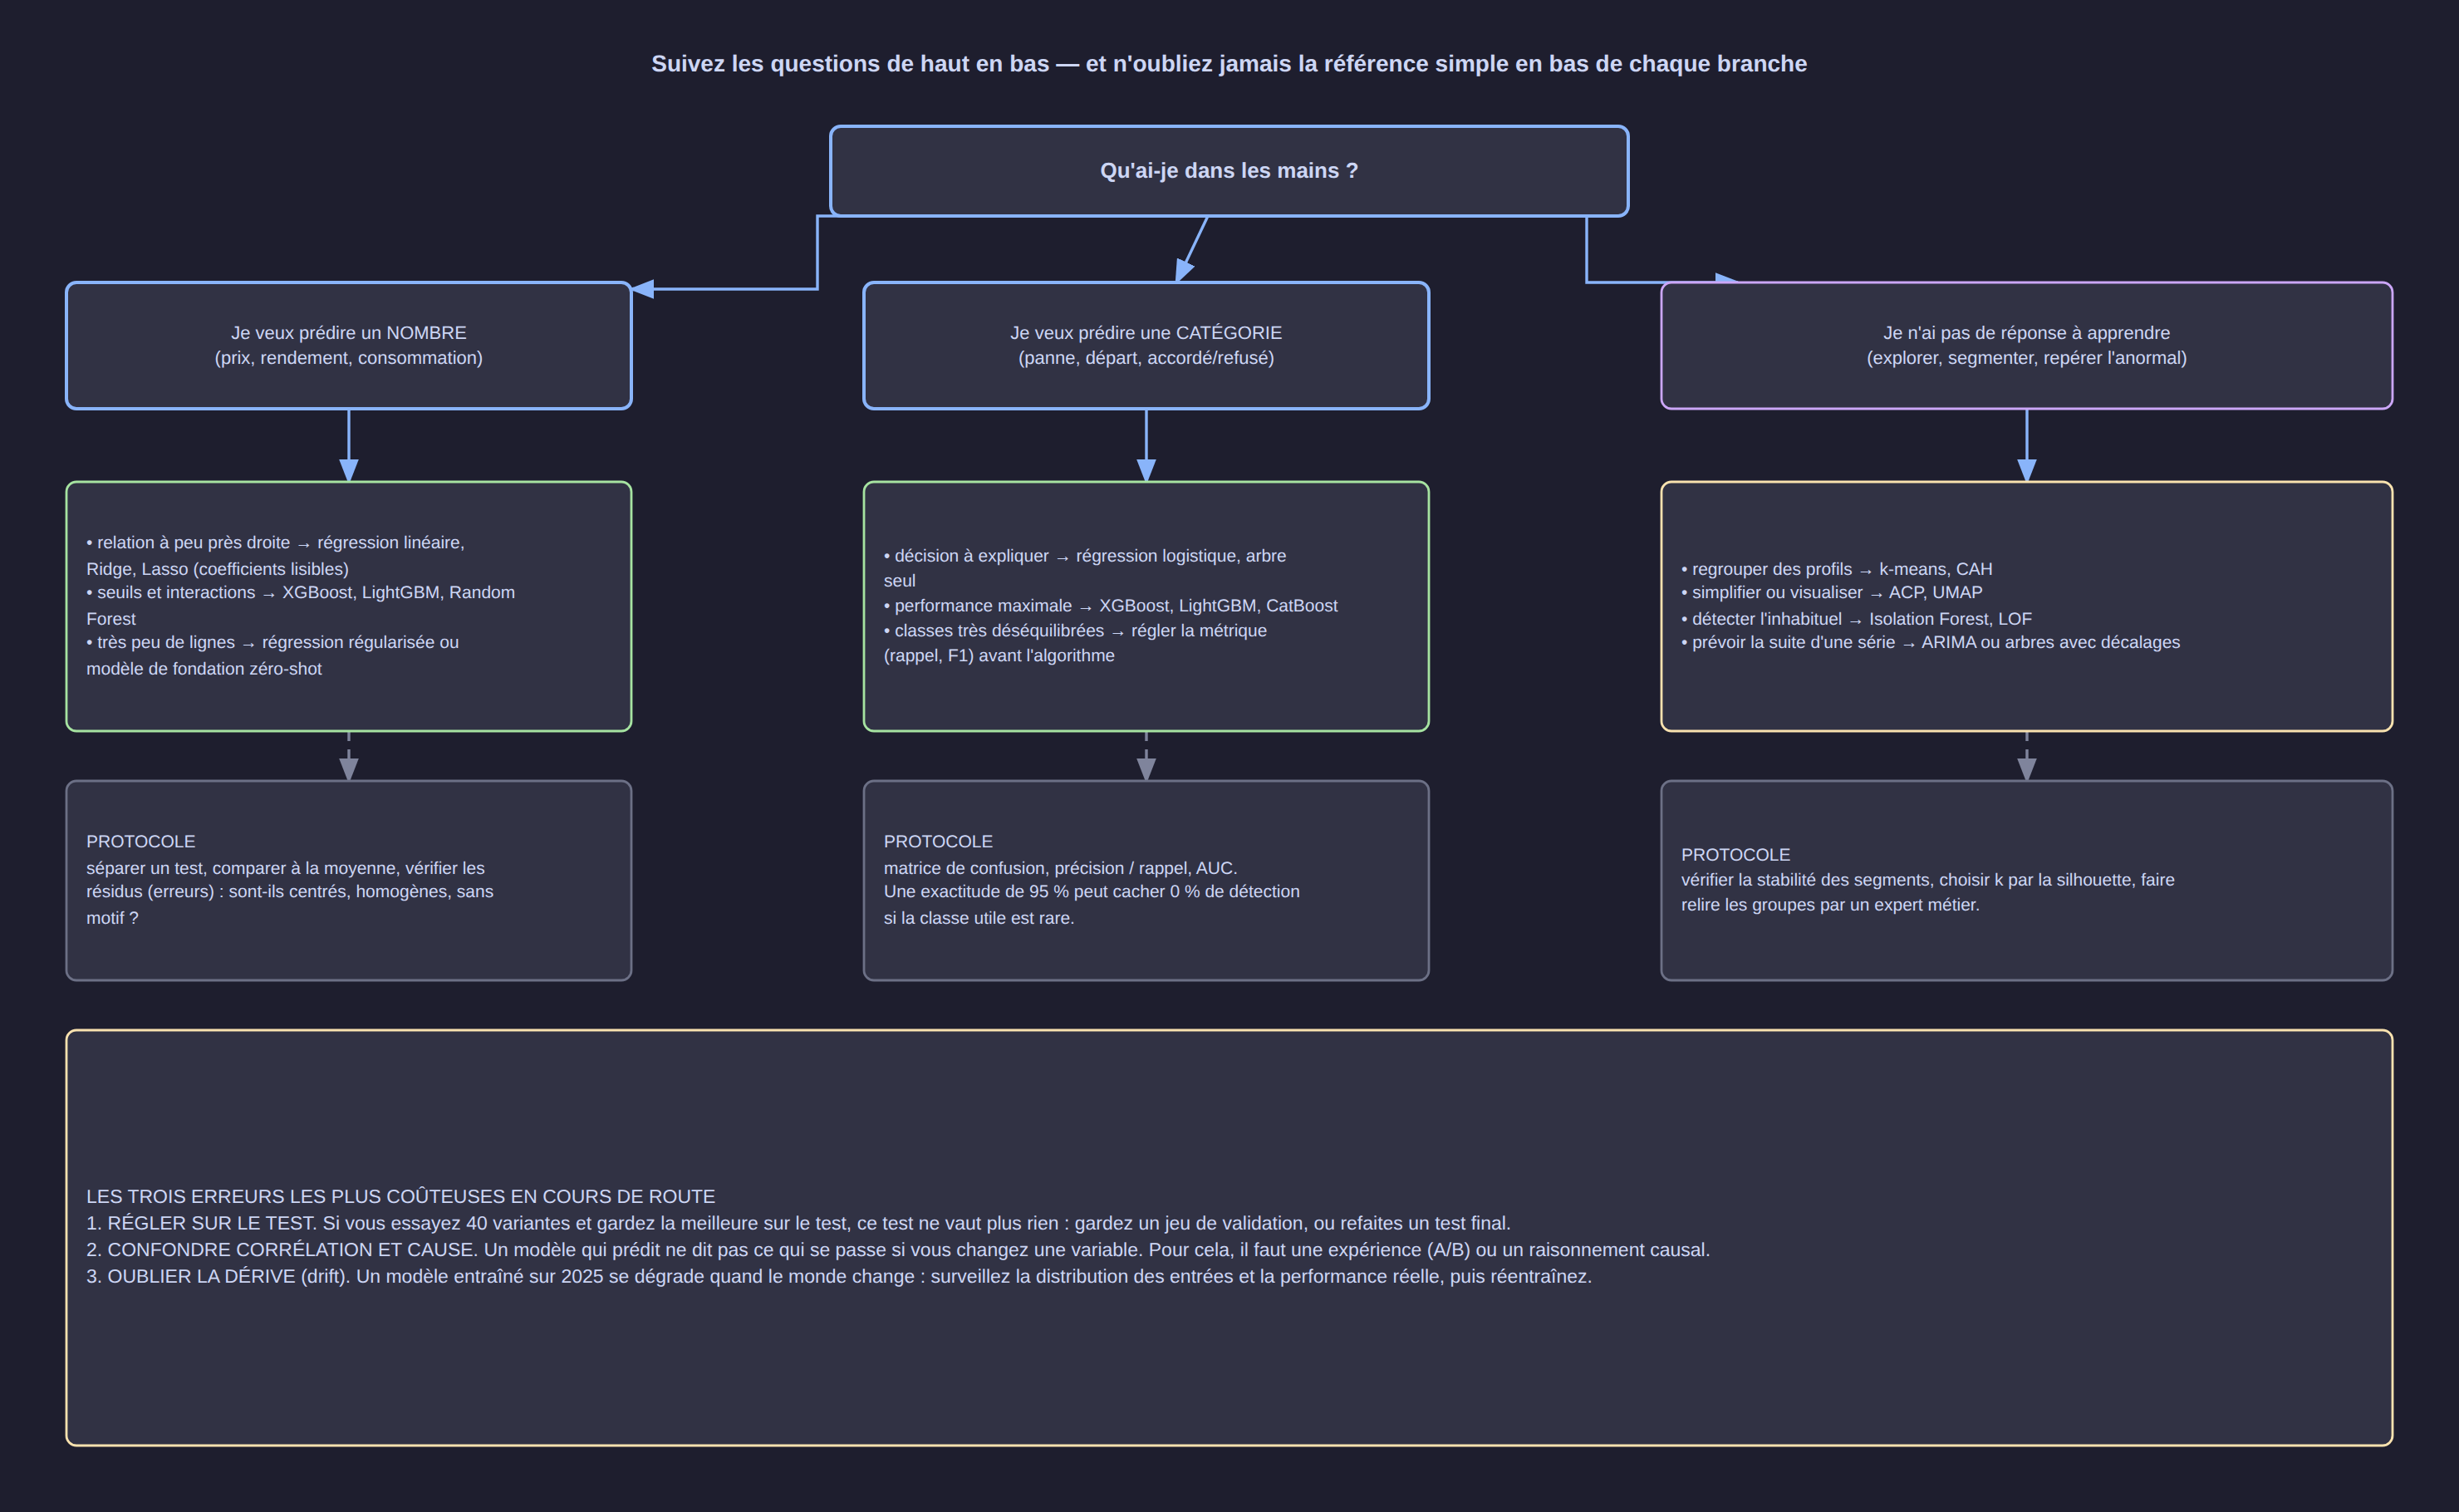
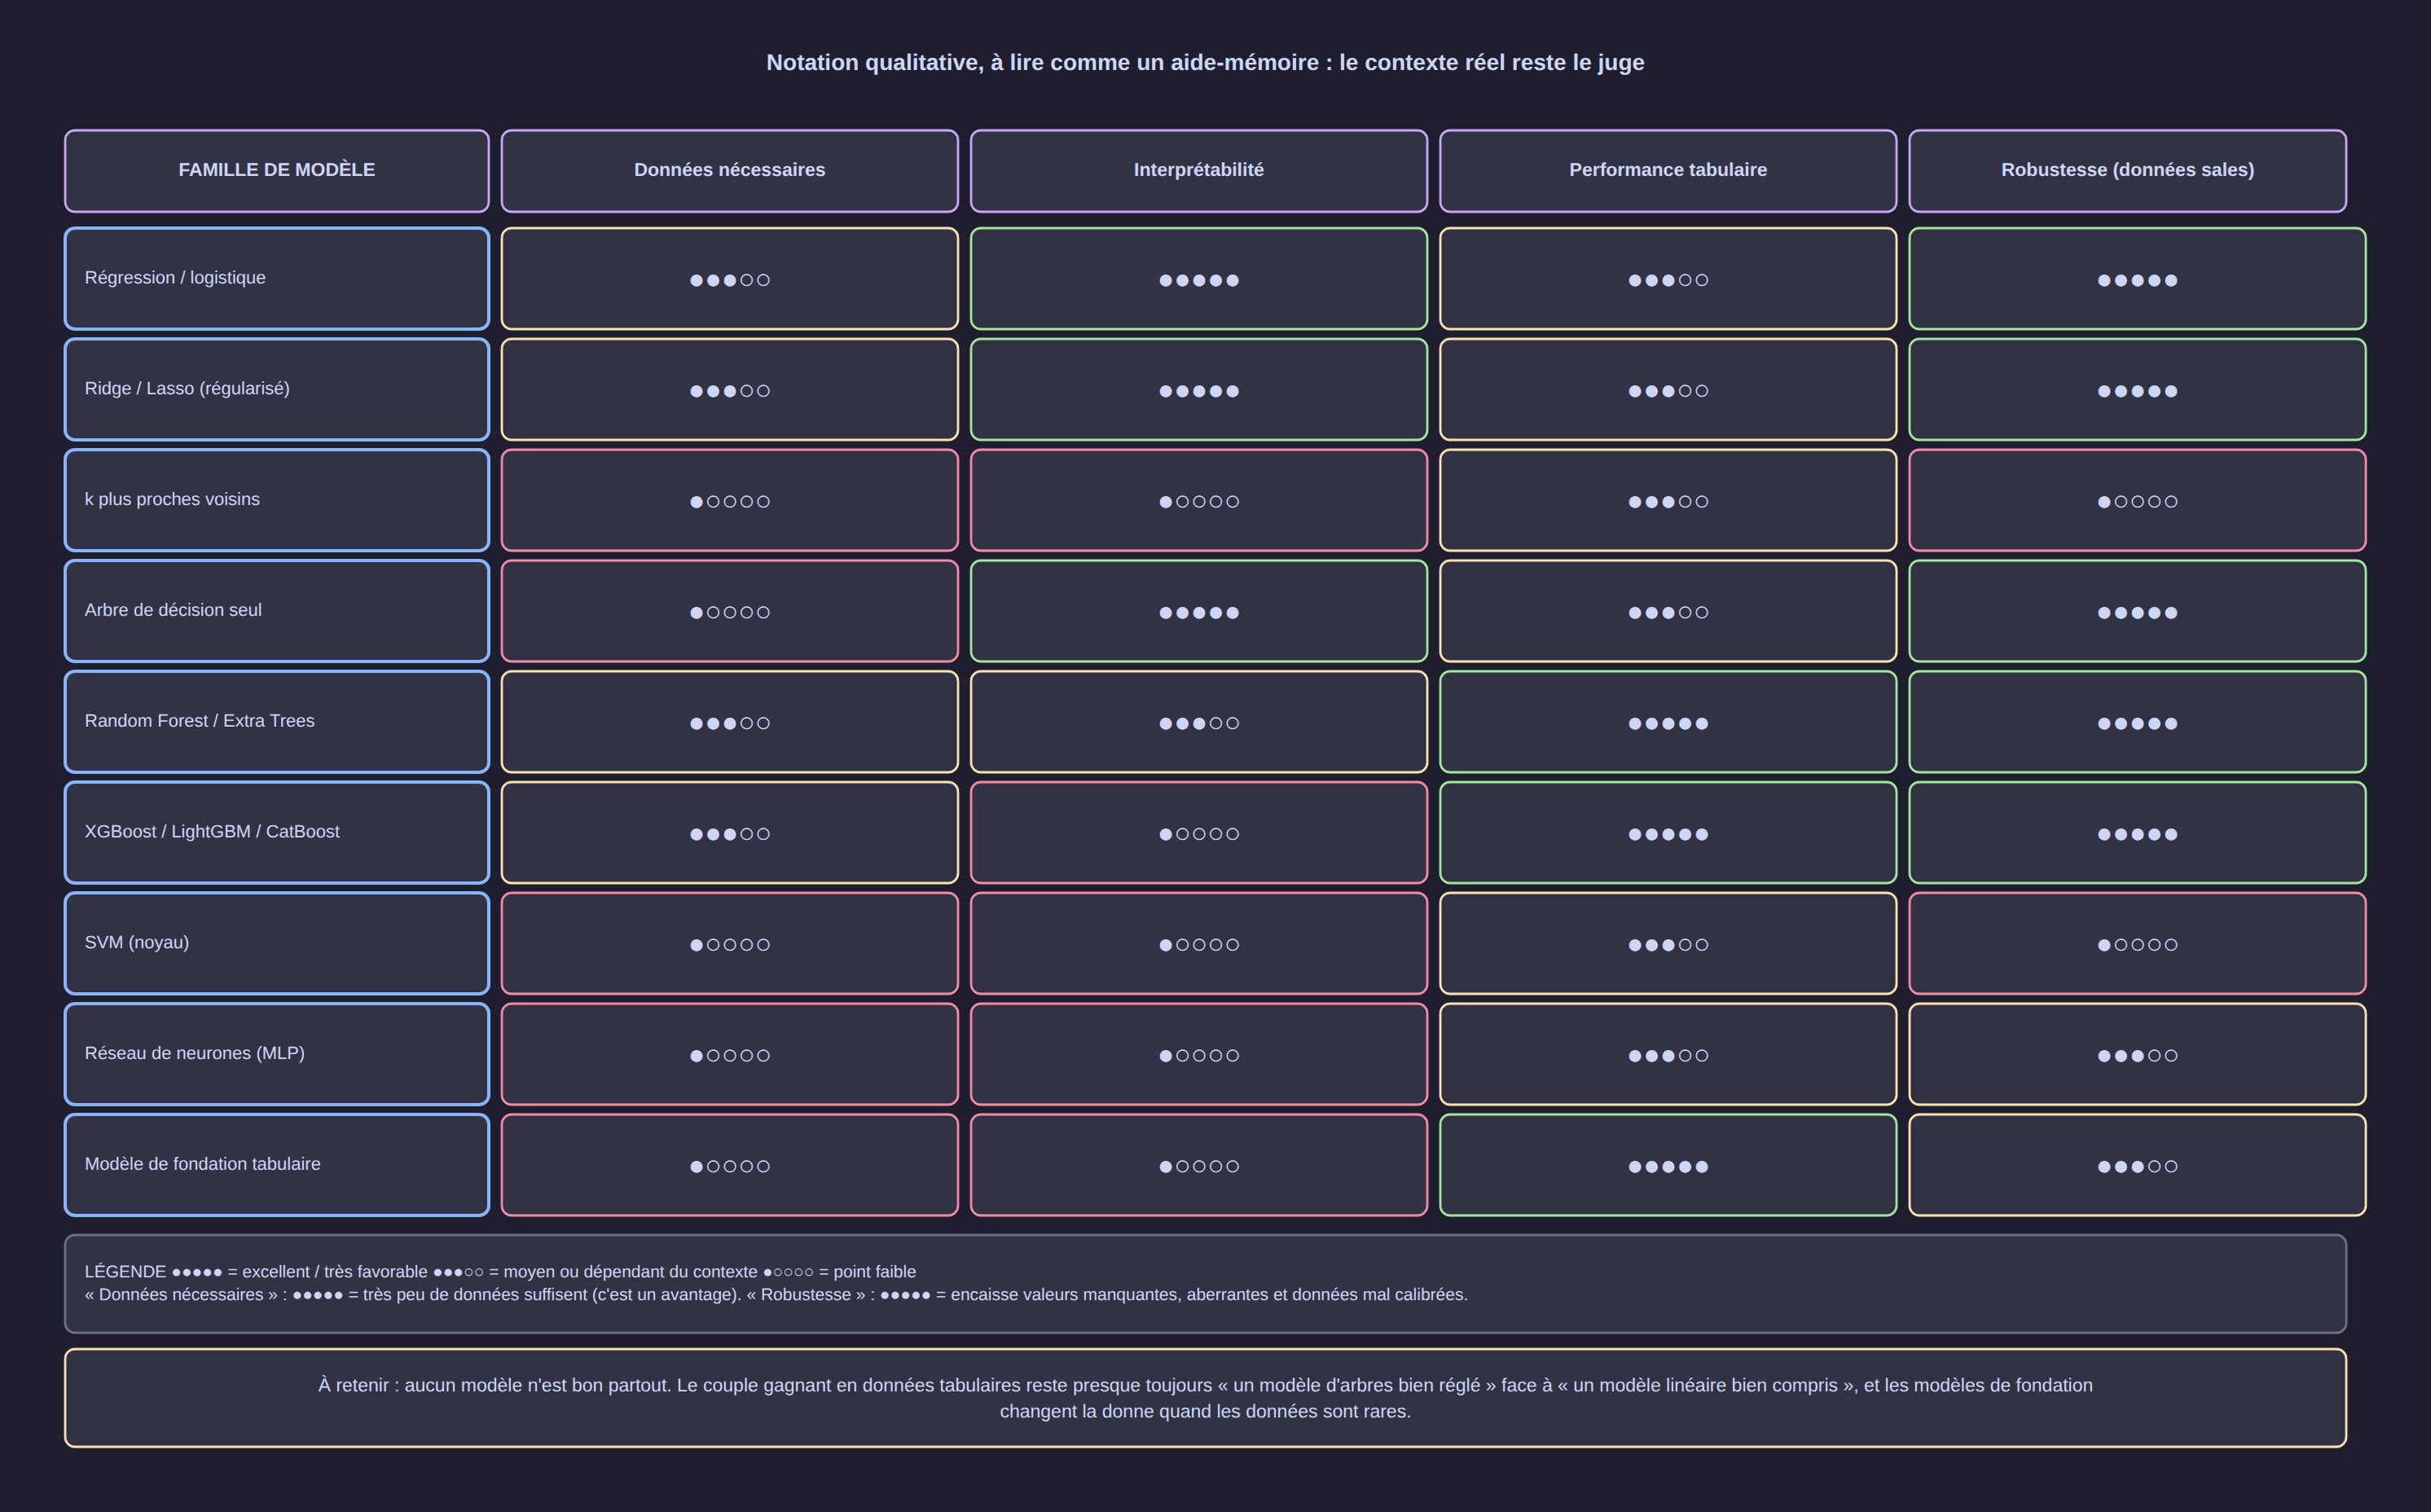
Le raccourci utile pour un projet tabulaire courant :
- Toujours en premier : une référence (moyenne / classe majoritaire) et, si les variables sont peu nombreuses, une régression linéaire ou logistique — pour l'interprétation et comme point de comparaison.
- Ensuite : un Random Forest (peu de réglages, robuste) ou XGBoost/LightGBM (performance) — et on compare honnêtement.
- Données très rares (< 1 000 lignes) : un modèle de fondation tabulaire zéro-shot change la donne ; la régression régularisée reste une excellente base.
- Beaucoup de colonnes, peu de lignes : Lasso/Ridge ou modèles à noyau, plus une réduction de dimension (voir l'article compagnon).
- Beaucoup de données non structurées : réseaux profonds — c'est leur terrain.
9. Les cinq erreurs qui coûtent cher
- Régler les hyperparamètres sur le jeu de test. Après 40 essais, le « meilleur » score est un hasard chanceux. Utilisez une validation séparée, puis un test final unique.
- Oublier la référence. Sans elle, impossible de savoir si le modèle apporte quelque chose.
- Confondre prédiction et causalité. Un modèle prédit ; il ne dit pas ce qui se passe si l'on change une variable. Pour cela : expérience contrôlée ou raisonnement causal.
- Ignorer le déséquilibre des classes. 95 % d'exactitude peut signifier « ne détecte rien » quand la classe utile représente 5 % des cas : regardez rappel et F1.
- Ne rien surveiller en production. Les données dérivent (tarifs, matériel, comportement). Sans suivi de la distribution des entrées et de la performance réelle, le modèle se dégrade en silence.
10. Méthode de travail en sept étapes
- Formuler la décision que le modèle doit éclairer (pas « prédire X », mais « décider quoi, quand, avec quelle erreur acceptable »).
- Construire la table : une ligne = un cas, une colonne = une information disponible à la date de décision.
- Poser la référence simple et la métrique qui correspond au coût réel de l'erreur.
- Séparer les données (train / validation / test), en respectant le temps quand c'est temporel.
- Essayer deux ou trois familles, pas quinze : un linéaire interprétable, un ensemble d'arbres, éventuellement un modèle de fondation.
- Lire les erreurs : où le modèle se trompe-t-il ? Y a-t-il un motif (une région, une saison, un type de client) ? C'est là que se trouve le prochain gain, pas dans le choix de l'algorithme.
- Mettre en service, mesurer, réentraîner : versionner le modèle et les données, surveiller la dérive, prévoir la date du prochain réentraînement.
11. À retenir
- Les familles qui couvrent l'essentiel du travail réel : linéaire régularisé, arbres seuls, forêts d'arbres (bagging), boosting (XGBoost/LightGBM/CatBoost), distances (k-NN, SVM), probabiliste (Naive Bayes), réseaux de neurones — et désormais les modèles de fondation.
- En données tabulaires de taille petite ou moyenne, les ensembles d'arbres restent la référence, les modèles linéaires apportent l'explication, et les modèles de fondation brillent quand les données sont rares.
- Le gain vient rarement de l'algorithme : il vient de la question posée, de la qualité de la table et de l'honnêteté du protocole de test.
- Un modèle se choisit sur quatre critères simultanés : performance, explicabilité, coût, robustesse — exactement les colonnes de la matrice du §8.
Ressources
- Benchmarks et scripts : les données et les figures sont publiées sur le portail data-science.pauldiop.com ; le code des expériences accompagne le projet solaire de Badoudou.
- Documentation de référence : scikit-learn — guide des modèles supervisés, XGBoost, LightGBM, CatBoost
- Interprétation : SHAP pour expliquer les modèles d'arbres
- Articles liés : Modèles de fondation tabulaires — TabFM et Amazon Mitra-v2 ; article compagnon : Non supervisé, séries temporelles et détection d'anomalies