Non supervisé, séries temporelles et détection d'anomalies — panorama
Last reviewed: 19 septembre 2026
Que fait-on quand il n'y a aucune réponse à apprendre ? Comment prévoit-on une série qui évolue dans le temps ? Comment repère-t-on ce qui est inhabituel sans avoir jamais vu d'anomalie ? Ce guide couvre les trois familles qui répondent à ces questions, avec les mêmes règles que dans l'article compagnon : comment ça décide, forces, limites, cas d'usage, et des chiffres calculés sur des données réelles de production solaire au Sénégal.
Article compagnon : Les modèles supervisés — panorama, avantages, limites et cas d'usage (régression, arbres, boosting, SVM, réseaux de neurones, benchmark de 14 modèles).
1. Trois usages, une même absence d'étiquette
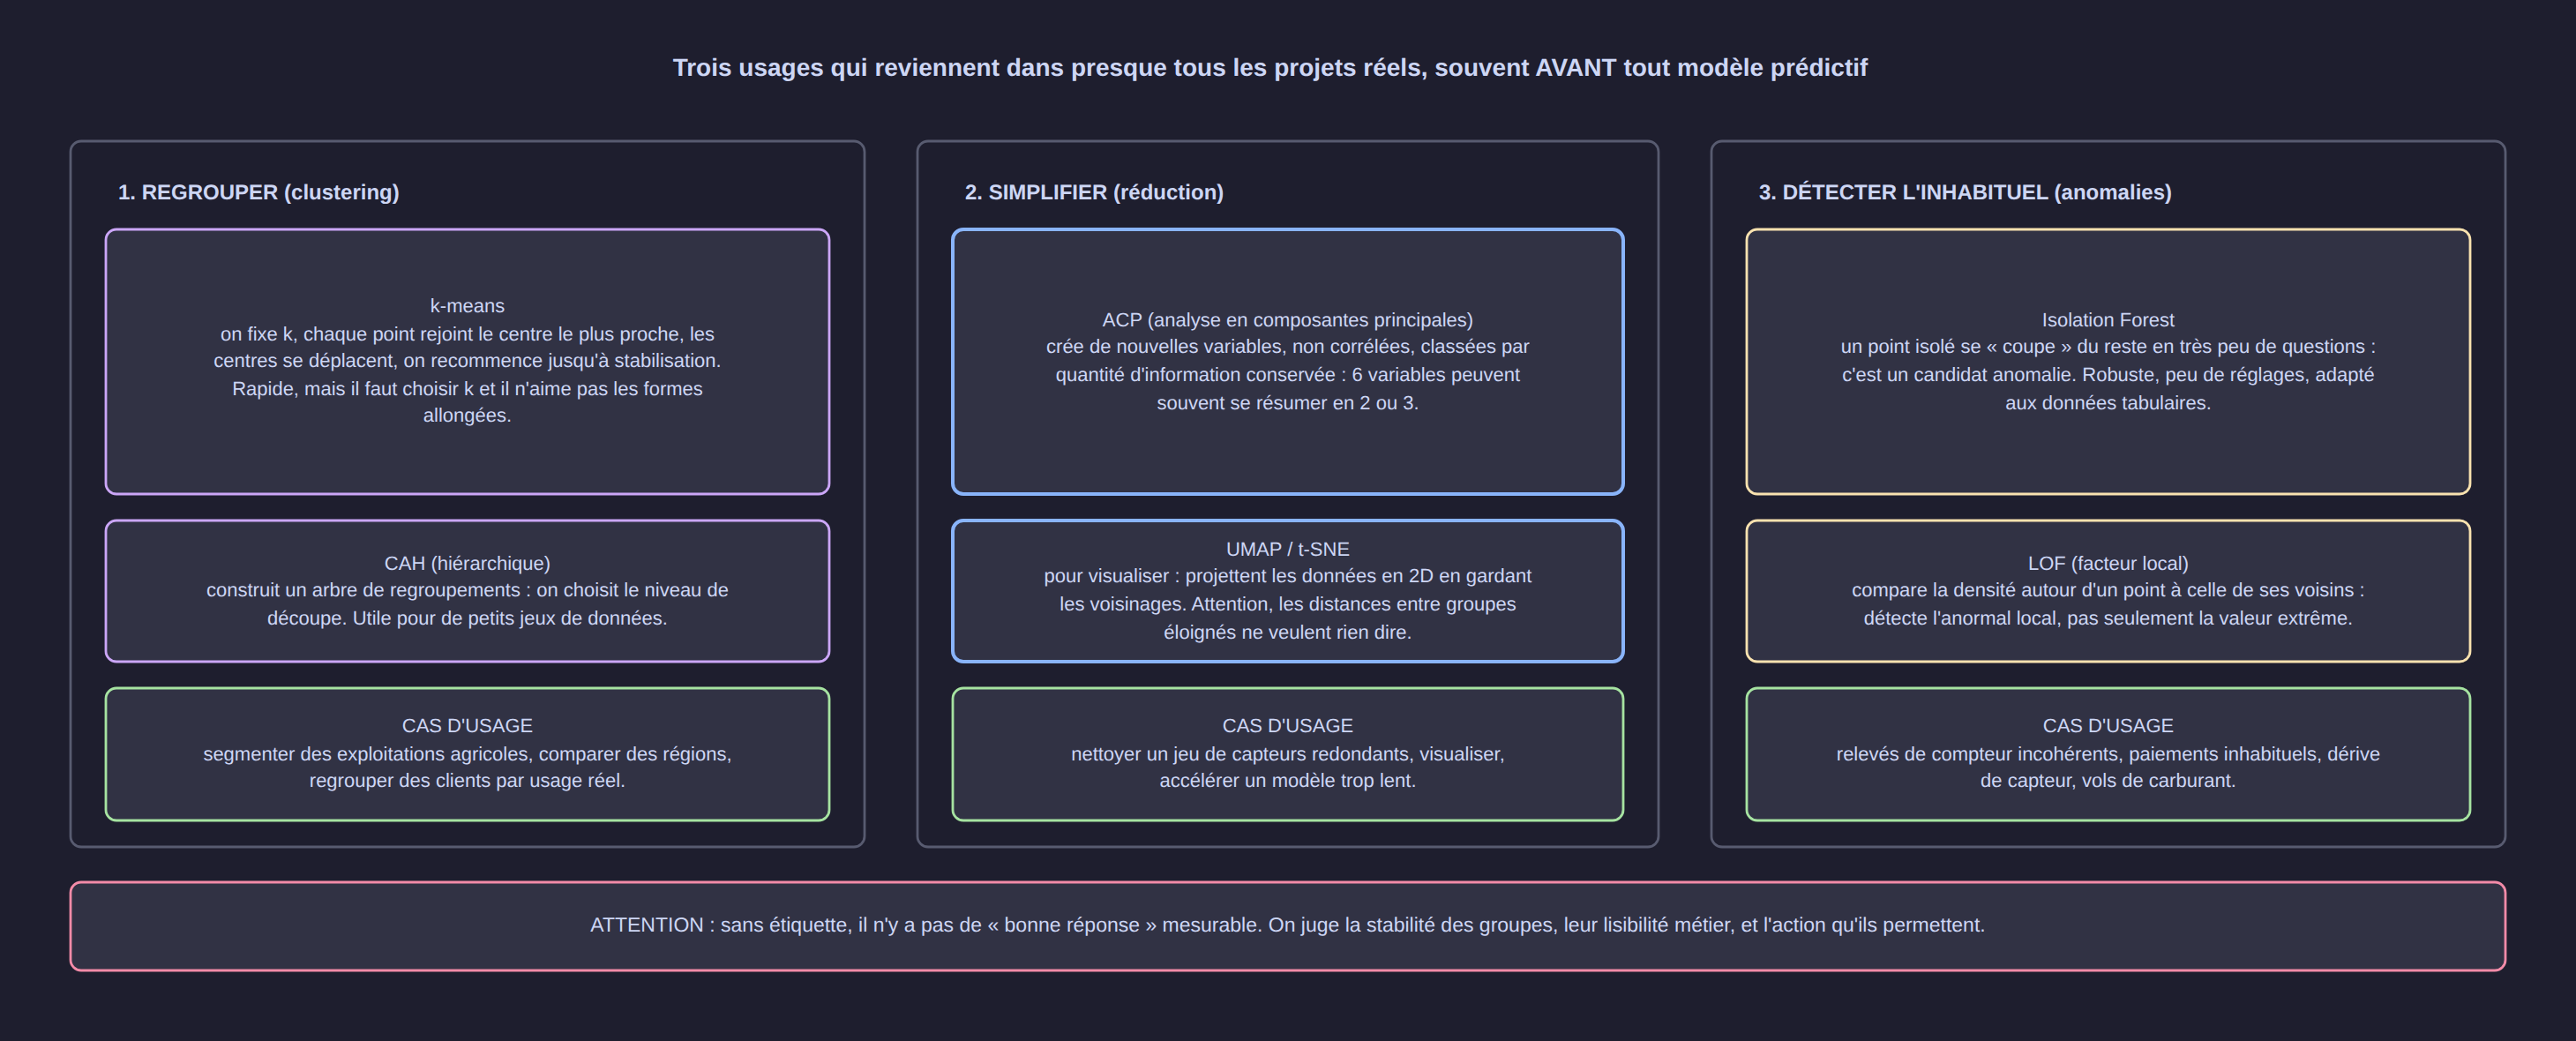
Dans un projet supervisé, on sait ce qu'on veut prédire. Ici, non :
| Objectif | Question posée aux données | Familles |
|---|---|---|
| Regrouper | « Quels profils se ressemblent ? » | k-means, CAH, DBSCAN |
| Simplifier | « Comment résumer 30 variables en 3 ? » | ACP, UMAP, t-SNE |
| Détecter l'inhabituel | « Qu'est-ce qui sort du lot ? » | Isolation Forest, LOF, SVM une classe |
[!IMPORTANT] Sans étiquette, il n'existe aucune mesure de « bonne réponse ». On ne peut pas calculer une exactitude. On juge donc trois choses : la stabilité du résultat (le groupe tient-il si l'on change l'échantillon ou l'algorithme ?), sa lisibilité métier (un expert reconnaît-il le groupe ?), et son utilité (permet-il une décision différente ?). C'est la différence culturelle la plus difficile à faire passer quand on vient du supervisé.
2. Regrouper : k-means, CAH, DBSCAN
2.1 k-means — le plus utilisé, et le plus mal utilisé
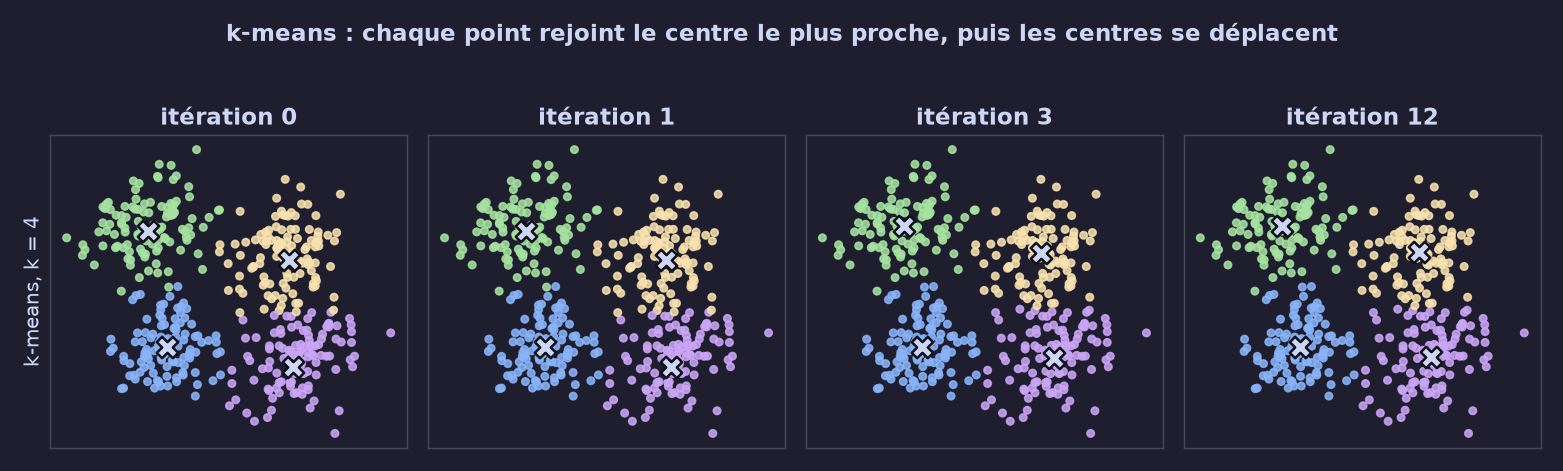
- L'idée : on fixe
k; chaque point rejoint le centre le plus proche ; les centres se déplacent vers la moyenne de leur groupe ; on recommence jusqu'à stabilisation. - Le réglage critique :
k(et le nombre d'initialisations aléatoires,n_init, pour éviter un mauvais départ). On le choisit avec un graphique du coude (inertie selonk), le score de silhouette, ou — mieux — la question métier (« je veux 4 segments commercialisables »). - Forces : rapide même sur des millions de lignes, simple à expliquer, facile à industrialiser.
- Limites : il faut fixer
k; il suppose des groupes de forme sphérique et de taille comparable ; il est sensible aux unités (il faut standardiser) et aux valeurs extrêmes ; il assigne tout point à un groupe, même quand le point est isolé. - Cas d'usage : segmenter des clients par usage, regrouper des parcelles comparables, classer des journées types de production.
from sklearn.preprocessing import StandardScaler
from sklearn.cluster import KMeans
from sklearn.metrics import silhouette_score
Z = StandardScaler().fit_transform(X)              # indispensable : même unité pour tous
km = KMeans(n_clusters=3, n_init=25, random_state=0).fit(Z)
print(silhouette_score(Z, km.labels_))              # > 0,5 : groupes nets ; < 0,3 : groupes flous
2.2 CAH (classification ascendante hiérarchique)
- L'idée : on regroupe de proche en proche, en construisant un arbre (dendrogramme) que l'on découpe au niveau souhaité.
- Forces : pas besoin de fixer
kau départ, arbre visuel très parlant, déterministe. - Limites : coûteux au-delà de quelques milliers de lignes, les regroupements sont irréversibles (une mauvaise fusion ne peut pas être défaite).
- Cas d'usage : petits jeux de données, besoin de montrer la hiérarchie (familles de produits, proximité de sites).
2.3 DBSCAN — les groupes par densité
- L'idée : un groupe est une zone dense ; les points isolés deviennent explicitement bruit.
- Forces : pas besoin de fixer
k, détecte des formes allongées, identifie les points aberrants. - Limites : réglage délicat (rayon
eps, nombre de voisinsmin_samples), et les densités très différentes dans un même jeu de données posent problème. - Cas d'usage : regroupement géographique, détection de zones atypiques, données bruitées.
2.4 Exemple réel : regrouper les 7 régions du Sénégal
On standardise puis on regroupe les profils mensuels de production (12 valeurs par région, données PVGIS) :
| Groupe trouvé (k-means, k = 2) | Régions | Rendement annuel |
|---|---|---|
| Groupe 1 — littoral nord-ouest | Dakar, Saint-Louis, Thiès | 1 755 à 1 836 kWh/kWc/an |
| Groupe 2 — centre, sud et est | Kaolack, Sokone, Tambacounda, Ziguinchor | 1 652 à 1 725 kWh/kWc/an |
Deux méthodes indépendantes (k-means et CAH) retrouvent les mêmes groupes — c'est le test de stabilité qui compte. Le score de silhouette reste modéré (0,34) : la séparation existe, mais elle n'est pas une frontière naturelle évidente. Conclusion honnête à écrire dans un rapport : « deux familles de profils se dégagent, principalement selon la latitude et la proximité de l'océan », et non « le Sénégal compte deux zones solaires ».
3. Simplifier : ACP, UMAP, t-SNE
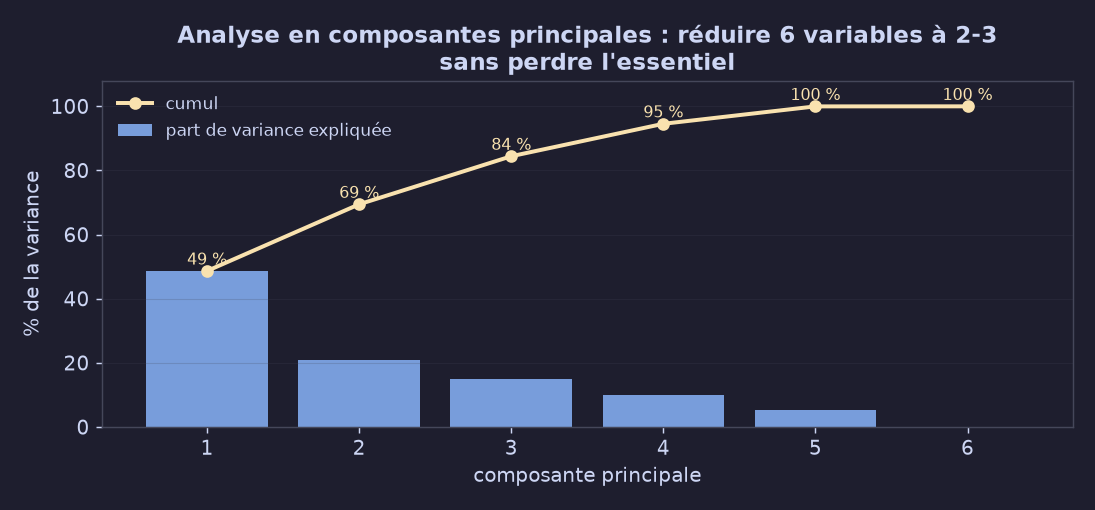
- ACP (analyse en composantes principales). Elle crée de nouvelles variables, non corrélées, classées par quantité de variance conservée. Sur notre jeu horaire, 2 composantes suffisent à résumer 91 % de l'information (73,5 % + 17,5 %).
- Ce qu'on y gagne : moins de colonnes donc modèles plus rapides et plus stables, visualisation en 2D, suppression de la redondance entre capteurs.
- Ce qu'on y perd : l'interprétation directe — la composante 1 est un mélange de plusieurs variables. Si l'explicabilité est une exigence, préférez la sélection de variables (Lasso, importance des arbres).
- UMAP et t-SNE servent à visualiser, pas à décider : ils préservent les voisinages, mais les distances entre groupes éloignés ne veulent rien dire. Une carte t-SNE n'est pas une carte géographique.
- Piège classique : appliquer l'ACP (ou tout autre prétraitement) sur l'ensemble des données avant de séparer l'entraînement du test fait fuiter de l'information. On ajuste le prétraitement sur l'entraînement, on l'applique au test.
4. Détecter l'inhabituel : Isolation Forest, LOF, SVM une classe
- Isolation Forest. Un point anormal se « coupe » du reste en très peu de questions aléatoires : la longueur du chemin mesure l'anormalité. Robuste, peu de réglages, adapté aux tableaux.
- LOF (Local Outlier Factor). Compare la densité locale d'un point à celle de ses voisins : détecte l'anormal local (une valeur normale globalement peut être bizarre dans son contexte).
- SVM une classe. Apprend la région « normale » et signale ce qui en sort ; utile quand la frontière est complexe.
- Autoencodeurs. Un réseau apprend à reconstruire les données normales ; une reconstruction médiocre signale l'anomalie — pertinent quand les données sont riches et nombreuses.
[!WARNING] L'évaluation est le vrai problème. Sans étiquette, un score de détection ne se calcule pas : imaginez une usine avec 1 % de cas détectables — un modèle qui ne signale jamais rien affiche 99 % d'exactitude ! En pratique : faites relire les 100 cas les plus anormaux par un expert, mesurez la proportion de vrais problèmes (« précision à k »), et comparez à la valeur métier (interventions évitées, fraude stoppée).
Trois conseils de terrain : commencez par des règles simples (seuils, plages plausibles, variations brutales) ; surveillez la distribution des variables dans le temps plutôt que de chasser l'anomalie unitaire ; et documentez chaque alerte avec sa cause probable — c'est ainsi qu'un système d'alerte devient crédible.
Cas d'usage réels : relevés de compteur incohérents, consommation nocturne anormale sur une installation solaire (batterie qui fuit, appareil oublié), dérive de capteur, paiements inhabituels, vol de carburant, panne naissante d'un équipement (vibration, température).
5. Séries temporelles : décomposer, décaler, valider dans le temps
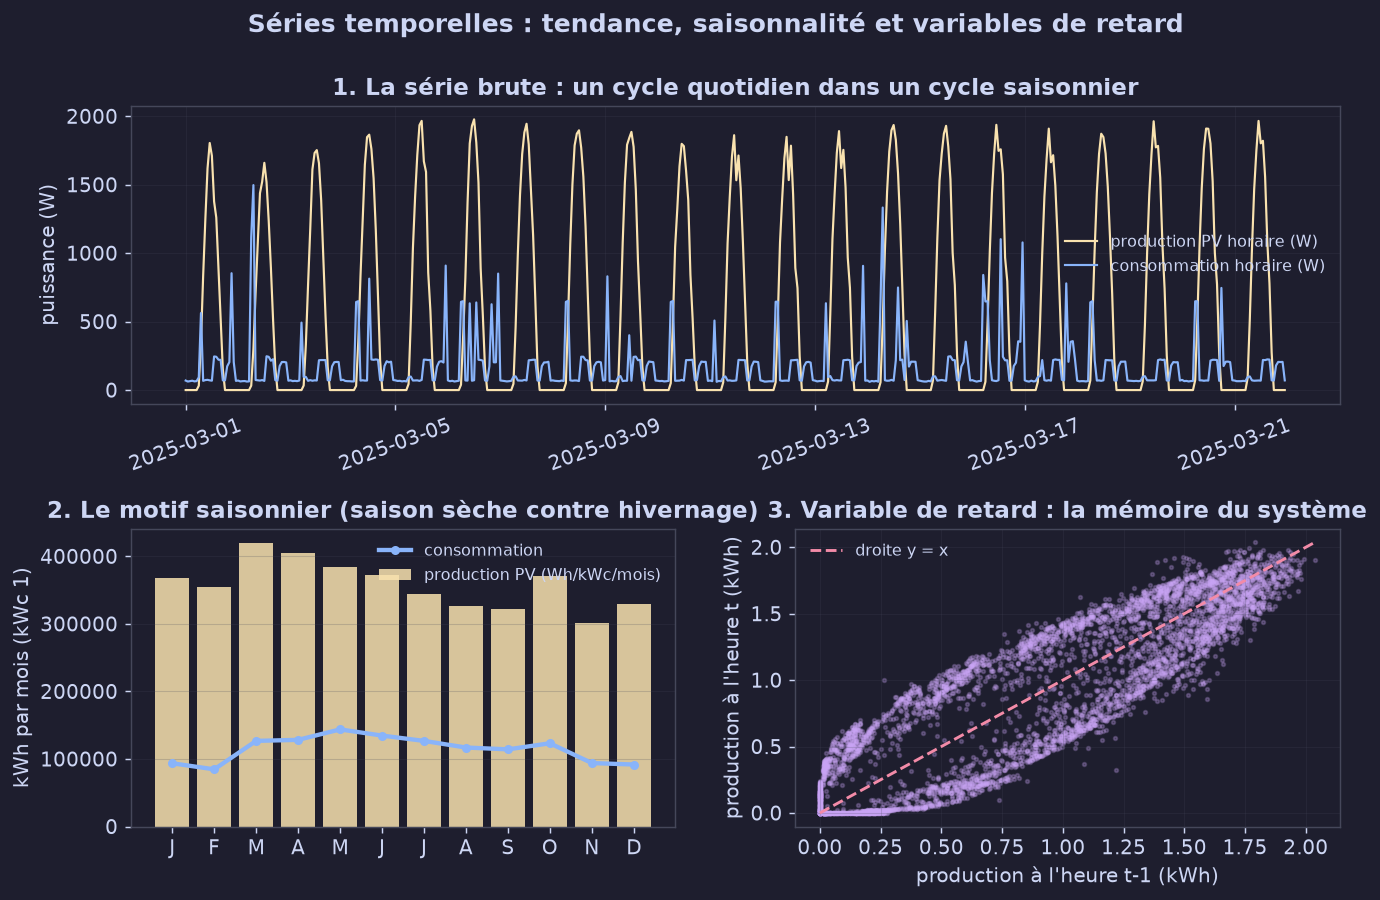
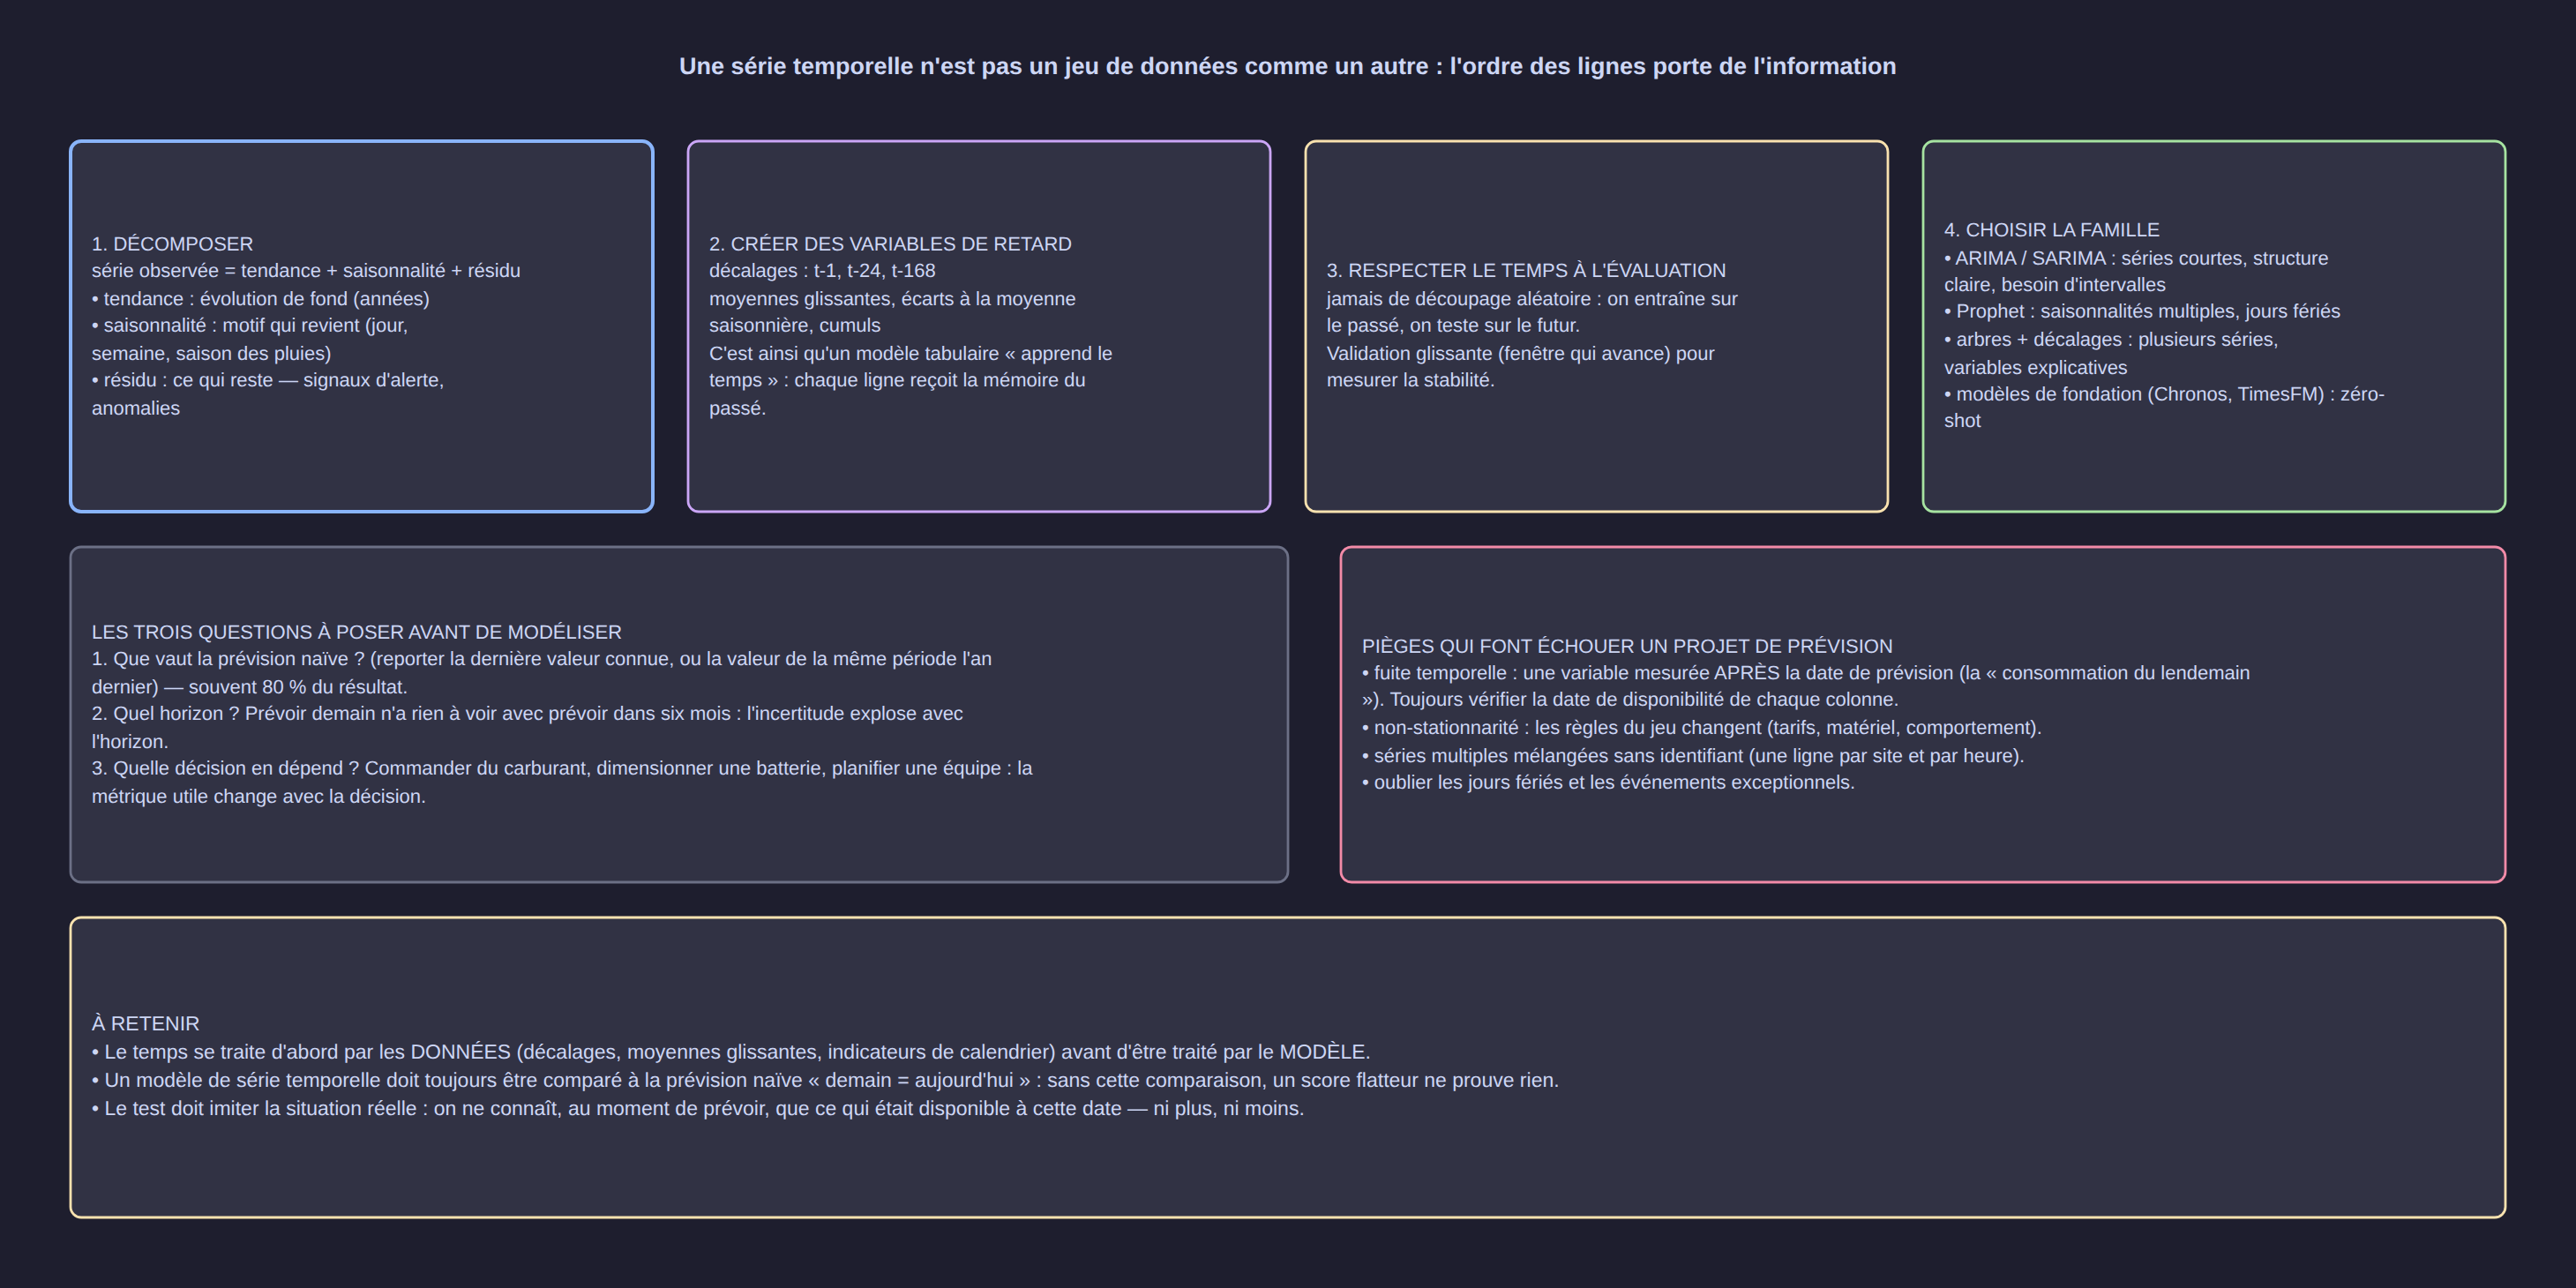
Une série temporelle n'est pas un jeu de données comme un autre : l'ordre des lignes porte de l'information. Trois idées à retenir avant tout algorithme :
- La série se décompose en tendance (évolution de fond), saisonnalité (motif qui revient : jour, semaine, saison des pluies) et résidu. La figure ci-dessus est calculée sur nos données réelles : cycle quotidien dans un cycle saisonnier.
- Le temps se met dans les variables. Décalages (
t-1,t-24,t-168), moyennes glissantes, écart à la moyenne saisonnière, indicateurs de calendrier (jour férié, début de la saison des pluies). C'est ainsi qu'un modèle tabulaire apprend le temps. - On valide sur le futur. Jamais de découpage aléatoire : entraînement sur le passé, test sur du futur, puis validation glissante (fenêtre qui avance) pour mesurer la stabilité.
5.1 Les familles, et ce qu'elles savent faire
| Famille | Idée | Forces | Limites | Quand la choisir |
|---|---|---|---|---|
| Prévision naïve | « demain = aujourd'hui » ou « cette saison = la même l'an dernier » | gratuite, surprenamment difficile à battre | ignore les variables explicatives | toujours, comme référence |
| Lissage exponentiel / Holt-Winters | moyenne pondérée du passé, avec tendance et saisonnalité | simple, robuste, intervalle direct | peu de variables explicatives | séries courtes, besoin d'intervalles lisibles |
| ARIMA / SARIMA | modélise l'autocorrélation de la série | cadres théoriques solides, ordres interprétables | réglage délicat, linéaire, saisonnalités multiples mal gérées | séries uniques et structurées |
| Prophet et apparentés | tendance par morceaux + saisonnalités + jours fériés | configurable par un non-statisticien, gère les trous | boîte noire, peut sur-lisser | séries métier avec calendrier chargé |
| Arbres + décalages (XGBoost, LightGBM) | transforme la série en table de décalages | souvent la meilleure performance, gère plusieurs séries et des variables explicatives | beaucoup de variables à construire, risque de fuite temporelle | plusieurs séries comparables, variables exogènes disponibles |
| Modèles de fondation de séries (Chronos, TimesFM) | pré-entraînés sur d'immenses catalogues de séries, prédisent en zéro-shot | immédiat, utile quand l'historique est court | nouvelles, résultats dépendants du domaine, coût d'inférence | démarrage rapide, séries nombreuses et courtes |
5.2 Mesurer une prévision
- MAE : erreur moyenne en unités métier (kWh, FCFA) — la plus parlante pour décider.
- RMSE : pénalise davantage les grosses erreurs, utile quand elles coûtent cher.
- MAPE : en pourcentage, pratique pour comparer plusieurs séries, mais explose quand la valeur réelle est proche de zéro — piège classique sur une production solaire nocturne nulle.
- Toujours comparer à la prévision naïve, et regarder le biais (le modèle sous-estime-t-il systématiquement ?).
5.3 Les pièges qui tuent un projet de prévision
- Fuite temporelle. Une variable mesurée après la date de prévision. Vérifiez, colonne par colonne, la date de disponibilité réelle des données.
- Mélanger des séries sans identifiant (une ligne par site et par heure, sans dire quel site).
- Oublier les événements : jours fériés, pannes, grèves, travaux, changement de matériel.
- Ignorer la non-stationnarité : tarifs, comportements et matériel changent — un modèle de 2024 n'est pas automatiquement valable en 2026.
6. Un raccourci de décision
- Vous cherchez des groupes → k-means (rapide, lisible), DBSCAN si les formes sont irrégulières et qu'il faut isoler du bruit. Vérifiez la stabilité avec une seconde méthode.
- Trop de colonnes → ACP pour résumer et accélérer ; UMAP/t-SNE uniquement pour visualiser.
- Repérer l'inhabituel → Isolation Forest en premier essai ; ajoutez LOF si l'anormalité dépend du contexte local.
- Prévoir une série → prévision naïve comme référence, puis arbres + décalages si vous avez des variables explicatives et plusieurs séries, ARIMA/lissage si la série est unique et courte, modèles de fondation si l'historique est très court.
7. Les cinq erreurs qui coûtent cher
- Chercher une « vérité » dans un regroupement. Un clustering est une hypothèse utile, pas une découverte. Faites-la valider par le métier et testez sa stabilité.
- Choisir
kparce que le graphique était joli. Unkse justifie par la décision qu'il permet (segments actionnables), la silhouette n'étant qu'un indice. - Interpréter des distances UMAP/t-SNE. Ces projections déforment l'espace : on y lit des voisinages, jamais des distances absolues.
- Valider une prévision avec un découpage aléatoire. Cela revient à connaître l'avenir : les scores deviennent excellents et faux.
- Livrer un détecteur d'anomalies sans processus. Une alerte n'a de valeur que si quelqu'un sait quoi en faire, et si l'on mesure combien d'alertes mènent à une action utile.
8. Méthode de travail
- Écrire la question métier et la décision qu'elle sert (« regrouper les clients pour adapter l'offre », « prévoir la consommation pour dimensionner la batterie »).
- Regarder les données : distribution, saisonnalité, valeurs manquantes, ruptures.
- Fixer la référence : prévision naïve, règle de seuil simple, ou segmentation en une variable.
- Essayer une famille, une seule, puis vérifier la stabilité (autre graine aléatoire, autre méthode, autre période).
- Faire lire les résultats par un expert métier : c'est le seul juge possible en non supervisé.
- Industrialiser : versionner, surveiller les distributions, planifier le réentraînement.
9. À retenir
- Non supervisé : aucune étiquette, donc aucune exactitude — on juge la stabilité, la lisibilité et l'utilité. k-means reste l'outil de base, l'ACP résume, Isolation Forest repère l'inhabituel.
- Séries temporelles : le temps se met d'abord dans les données (décalages, saisonnalité, calendrier), puis dans le modèle ; et l'on valide toujours sur le futur.
- La référence naïve est obligatoire partout — moyenne, classe majoritaire, « demain = aujourd'hui ».
- Les chiffres de cet article (groupes de régions, 91 % de variance en 2 composantes, saisonnalité réelle) viennent tous de données publiées : ils sont reproductibles.
Ressources
- Documentation : scikit-learn — clustering, décomposition, détection d'anomalies
- Séries temporelles : statsmodels, Prophet, Chronos, TimesFM
- Données et figures : portail data-science.pauldiop.com
- Articles liés : Les modèles supervisés — panorama ; TabFM et Mitra-v2 pour les modèles de fondation tabulaires