Google TabFM — Modèles de fondation tabulaires (prévision zéro-shot)
Last reviewed: 19 septembre 2026
Vous avez 84 lignes de données — pas 84 millions. Un modèle de fondation tabulaire peut-il prédire malgré tout, sans entraînement ni réglage ? Cet article explique comment ces modèles fonctionnent, ce qu'ils changent par rapport à un projet de data science classique, et le teste sur un cas réel au Sénégal : la production photovoltaïque contre la consommation électrique d'une maison à Badoudou, près de Sokone.
Ce que vous allez comprendre
- Ce qu'est un modèle de fondation tabulaire et pourquoi « tabulaire » veut dire « tableur » : des lignes, des colonnes, une cible à prédire.
- La différence entre apprendre en entraînant (projet classique) et apprendre en contexte (modèle de fondation), illustrée diagramme par diagramme.
- Comment TabFM de Google Research est construit : attention par colonnes, compression des lignes, Transformer d'apprentissage en contexte.
- Comment ces modèles se comportent sur un vrai petit jeu de données sénégalais de production solaire, face à XGBoost/Random Forest/une régression linéaire.
- Quand un modèle de fondation est le bon outil, et quand il ne l'est pas.
Aucun prérequis au-delà du lycée : chaque notion est expliquée au moment où elle apparaît.
1. Le problème : bien prédire coûte du temps, surtout quand les données sont rares
Un projet de machine learning classique suit toujours le même chemin : on nettoie les données, on fabrique des variables utiles, on choisit un modèle, on règle ses hyperparamètres, on l'entraîne, on évalue — et on recommence. Ce travail existe parce que le modèle part de zéro : il ne sait rien du monde avant de voir vos données.
Conséquence directe : plus vos données sont rares, plus le modèle a de mal à apprendre, et plus il risque d'apprendre « par cœur » vos quelques lignes (surapprentissage). Sur 84 lignes, un arbre de décision boosté peut afficher 99 % en apprentissage et se tromper lourdement sur de nouvelles données.
Les modèles de fondation renversent l'approche : ils ont déjà appris à apprendre, sur des centaines de millions de tables synthétiques, avant de vous rencontrer.
2. L'idée : un modèle qui a vu des millions de tables avant la vôtre
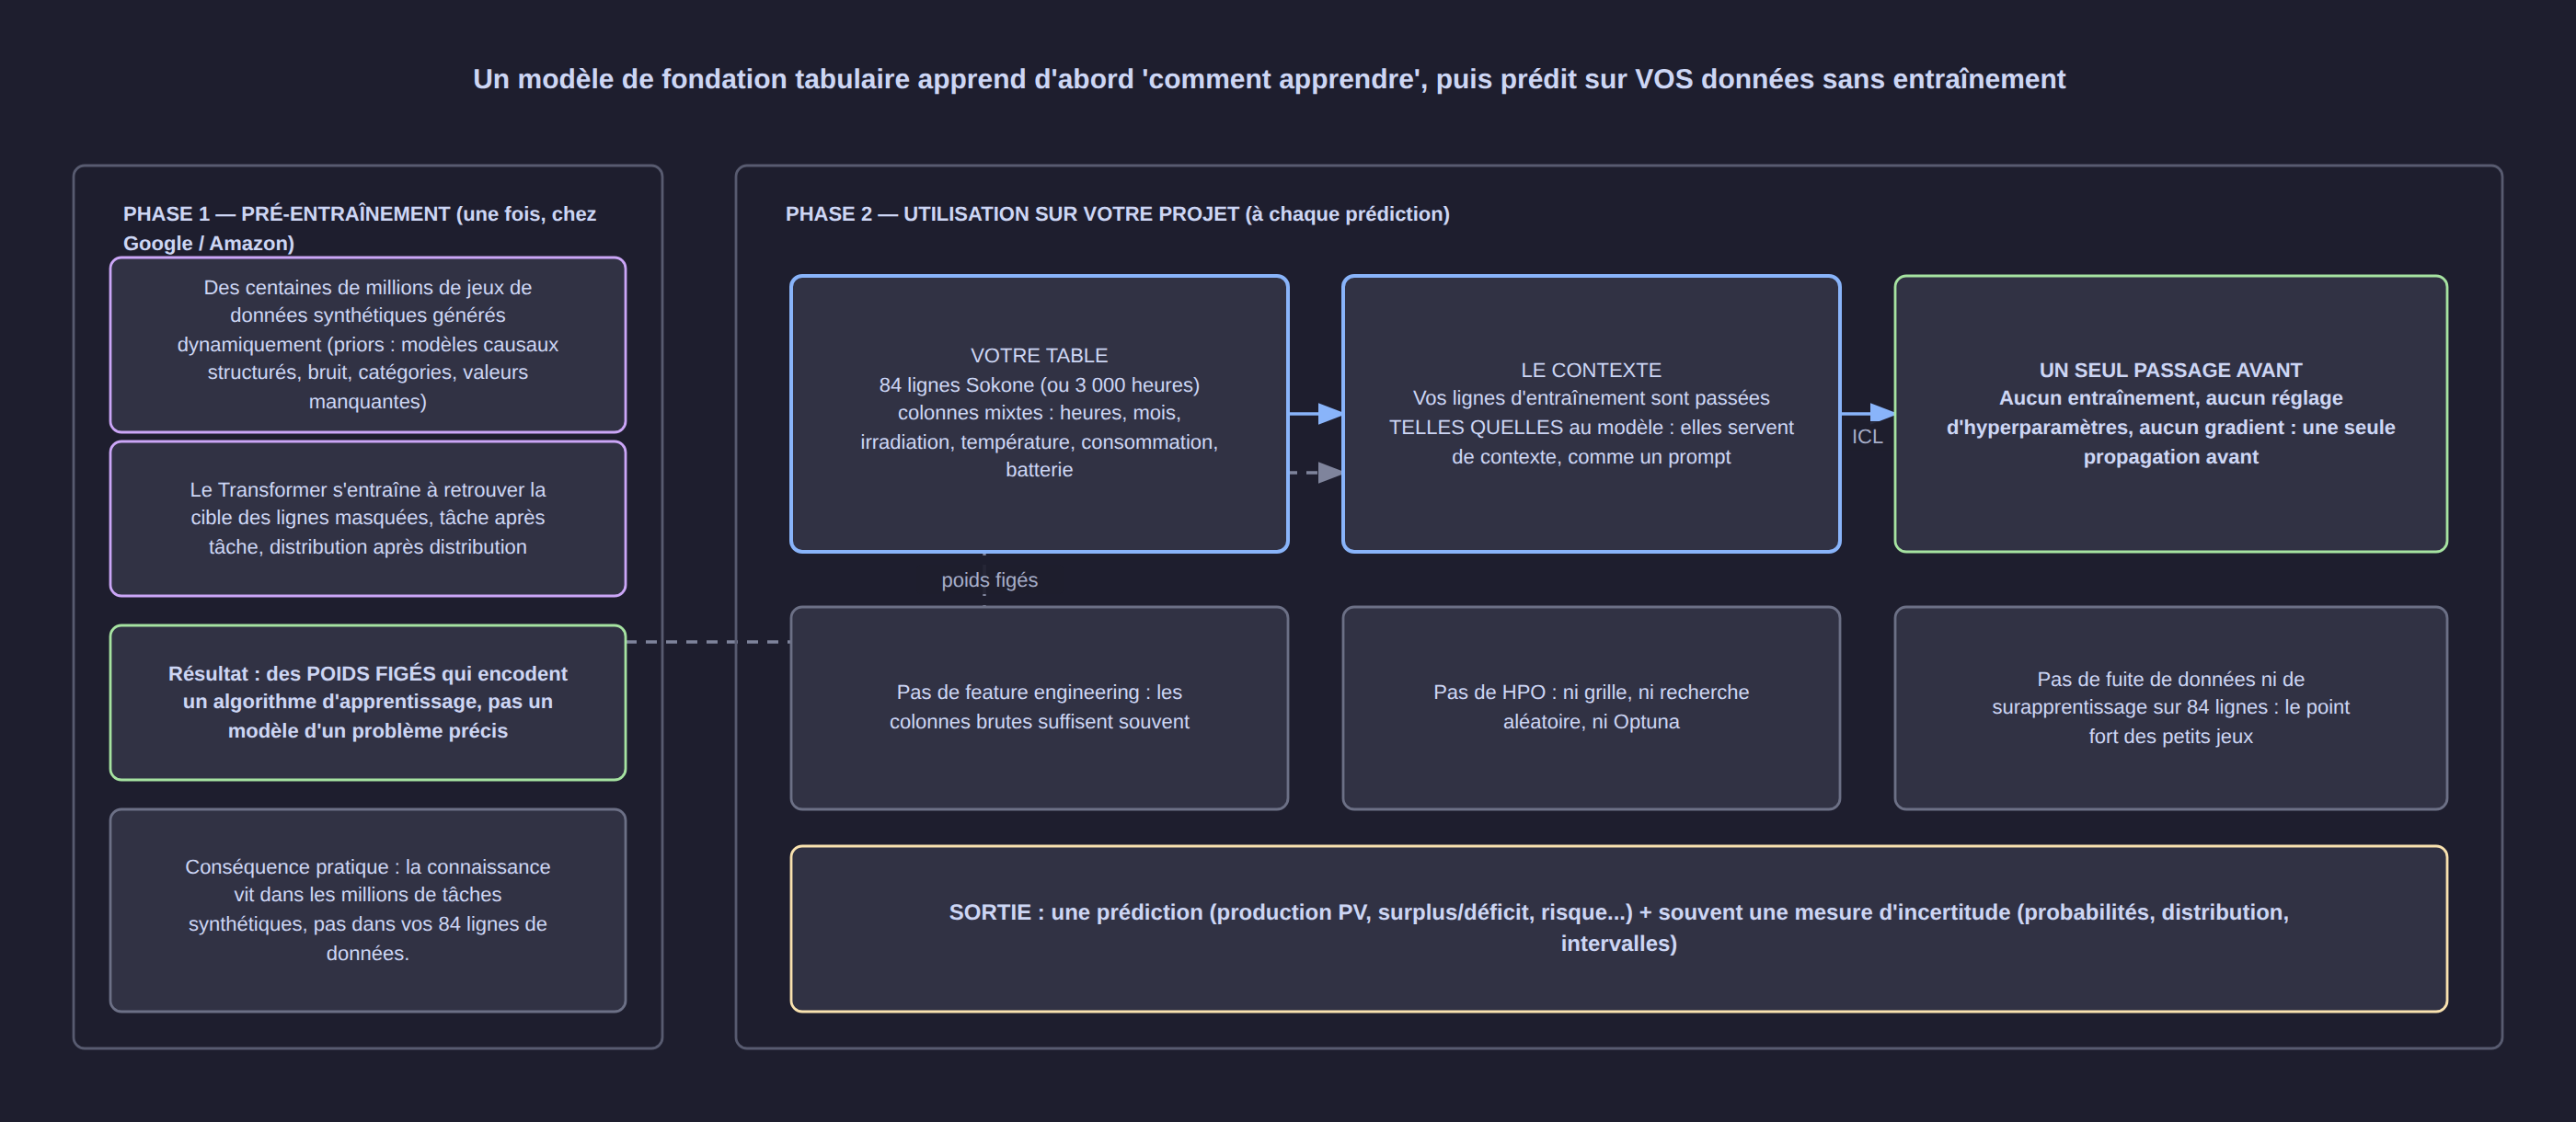
Le principe tient en trois temps :
- Générer des tâches synthétiques. On fabrique des millions de petits « problèmes » : des tables au hasard, avec des structures causales plausibles (une variable en influence une autre, certaines valeurs manquent, certaines colonnes sont catégorielles).
- Entraîner un Transformer à les résoudre. À chaque étape, le modèle reçoit une table dont une colonne est masquée et doit la reconstituer. Il ne s'entraîne pas sur un problème : il s'entraîne sur la famille de tous les problèmes.
- Utiliser le modèle sur vos données, sans entraînement. Vos lignes d'entraînement lui sont passées comme contexte, et il prédit les lignes de test en une seule propagation avant.
C'est cette dernière étape qu'on appelle apprentissage en contexte (in-context learning, ICL), par analogie avec un modèle de langue à qui l'on donne quelques exemples dans la consigne plutôt que de le réentraîner.
3. Projet classique contre modèle de fondation : ce qui change vraiment
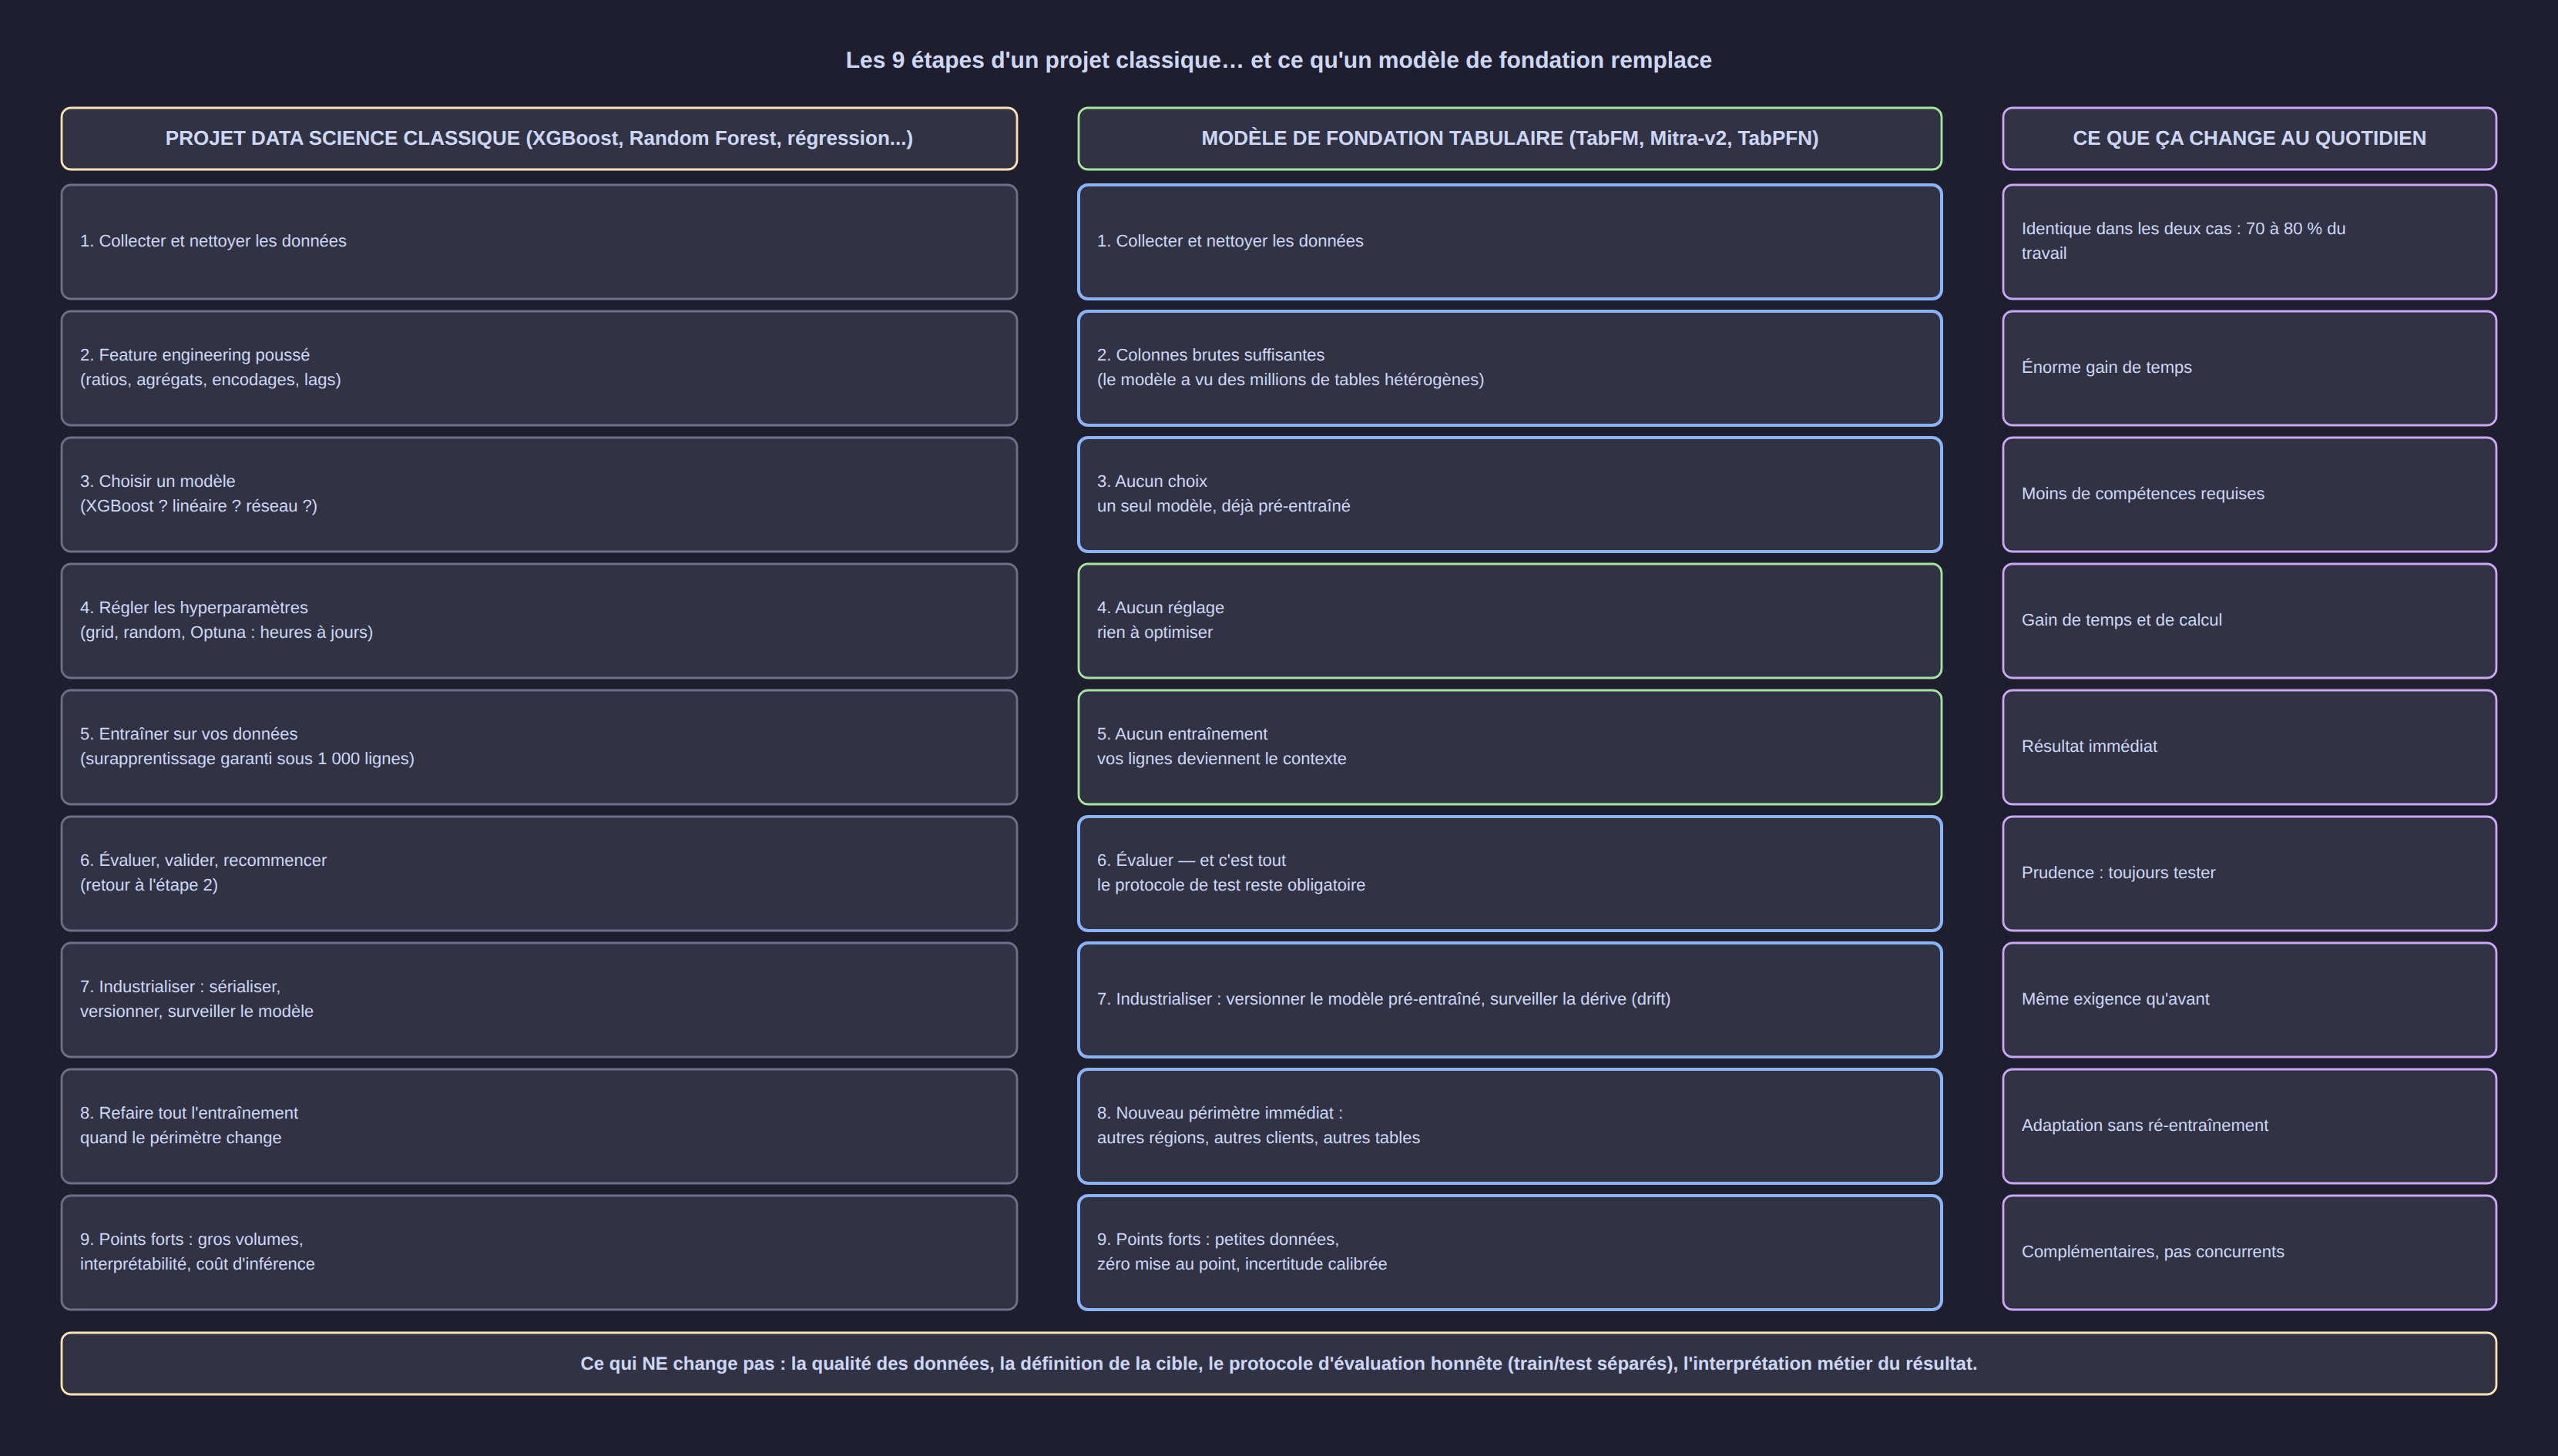
| Étape d'un projet classique | Avec un modèle de fondation |
|---|---|
| Nettoyage des données | Identique — 70 à 80 % du travail dans les deux cas |
| Feature engineering poussé (ratios, agrégats, encodages, décalages) | Les colonnes brutes suffisent souvent |
| Choix du modèle (XGBoost ? linéaire ? réseau ?) | Aucun choix : un seul modèle pré-entraîné |
| Réglage des hyperparamètres (grille, recherche aléatoire, Optuna) | Aucun réglage |
| Entraînement sur vos données | Aucun entraînement : vos lignes deviennent le contexte |
| Évaluation | Évaluation — le protocole de test reste obligatoire |
| Industrialisation (sérialisation, versionnage, dérive) | Même exigence : versionner le modèle pré-entraîné, surveiller la dérive |
| Reprise complète quand le périmètre change | Nouveau périmètre immédiat : autres régions, autres clients, autres tables |
Ce qui ne change pas : la qualité des données, la définition de la cible, la séparation entraînement/test, et l'interprétation métier du résultat. Un modèle de fondation ne remplace ni la rigueur ni la question posée ; il remplace les étapes de mise au point.
4. TabFM : comment Google Research l'a construit
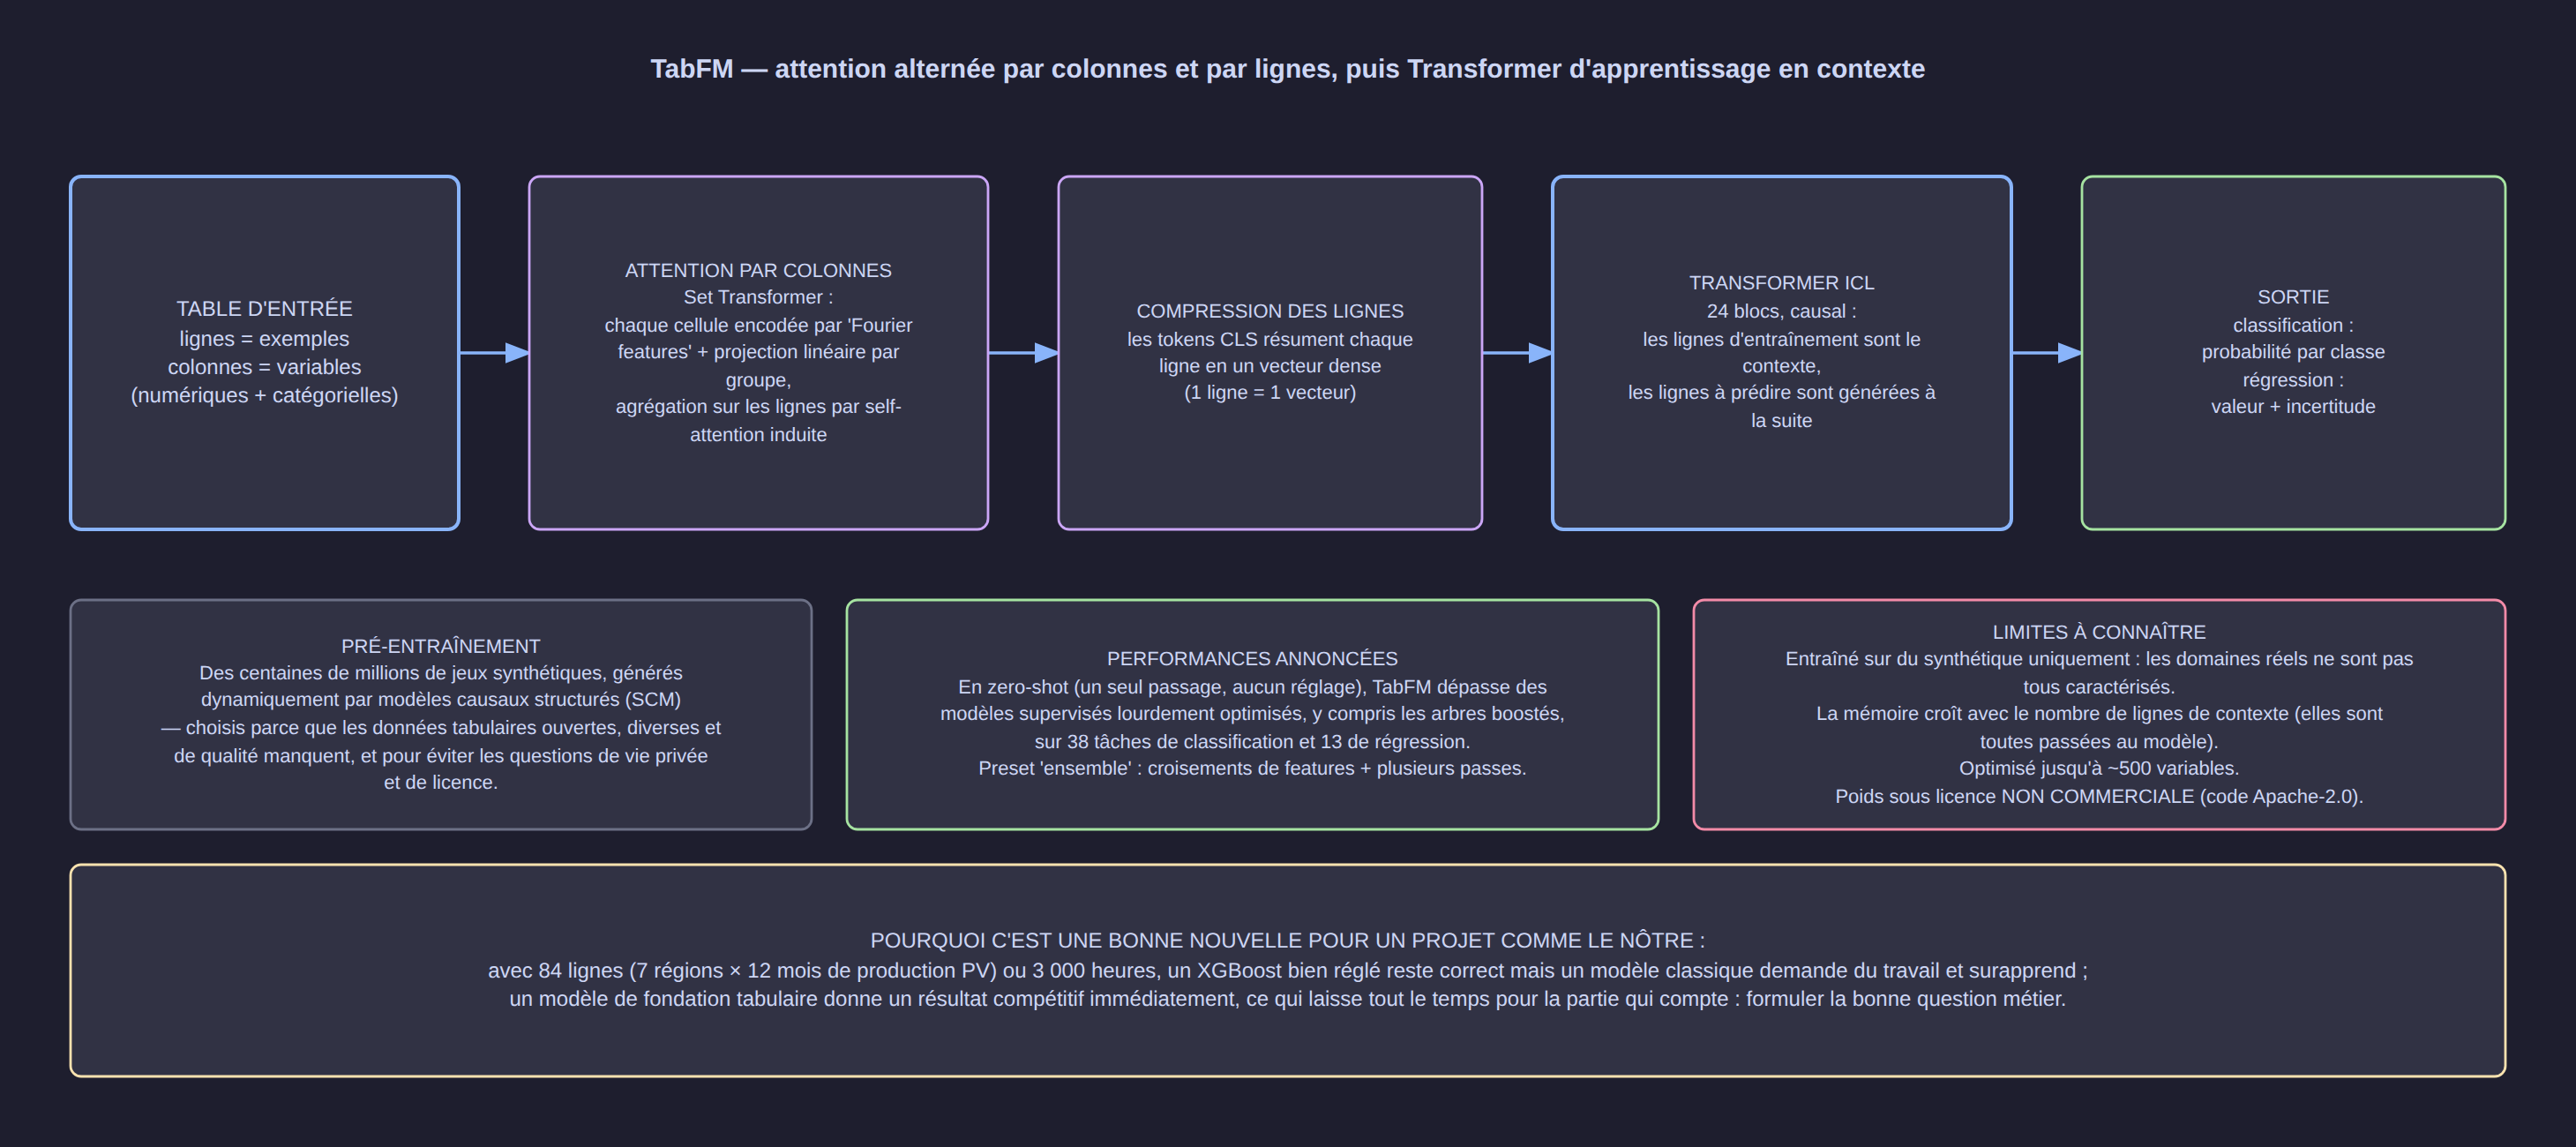
TabFM (Tabular Foundation Model, version 1.0.0, publiée en 2026) est un modèle de fondation tabulaire « zéro-shot » : il prédit la cible de lignes jamais vues en un seul passage.
Son architecture alterne deux directions d'attention :
- Attention par colonnes. Chaque cellule est encodée (caractéristiques de Fourier + projection linéaire par groupe de colonnes), puis les colonnes agrègent l'information à travers les lignes par self-attention induite — l'esprit d'un Set Transformer. C'est là que le modèle apprend les relations entre variables.
- Compression des lignes. Des jetons CLS résument chaque ligne en un vecteur dense : une ligne devient un point dans un espace de représentation.
- Transformer d'apprentissage en contexte. 24 blocs causaux traitent ces vecteurs de lignes : les lignes d'entraînement constituent le contexte, les lignes à prédire viennent « à la suite ».
TabFM a été pré-entraîné sur des centaines de millions de jeux de données synthétiques générés dynamiquement à partir de modèles causaux structurés (structural causal models). Le choix du synthétique est assumé par les auteurs : les tables ouvertes, diverses et de qualité manquent, et les données industrielles réelles posent des questions de vie privée et de licence.
D'après la fiche du modèle, en mode zéro-shot (un seul passage, aucun réglage), TabFM dépasse des modèles supervisés lourdement optimisés — arbres boostés compris — sur 38 tâches de classification et 13 tâches de régression.
[!NOTE] Licence à vérifier avant tout usage commercial. Le code de TabFM est publié sous licence Apache-2.0, mais les poids pré-entraînés sont distribués sous une licence « non commerciale » (
tabfm-non-commercial-v1.0). Pour un usage en production, il faut soit une autorisation, soit un autre modèle (TabPFN, Mitra-v2, ou un modèle classique).
5. Apprendre en contexte, ou modifier les poids ?
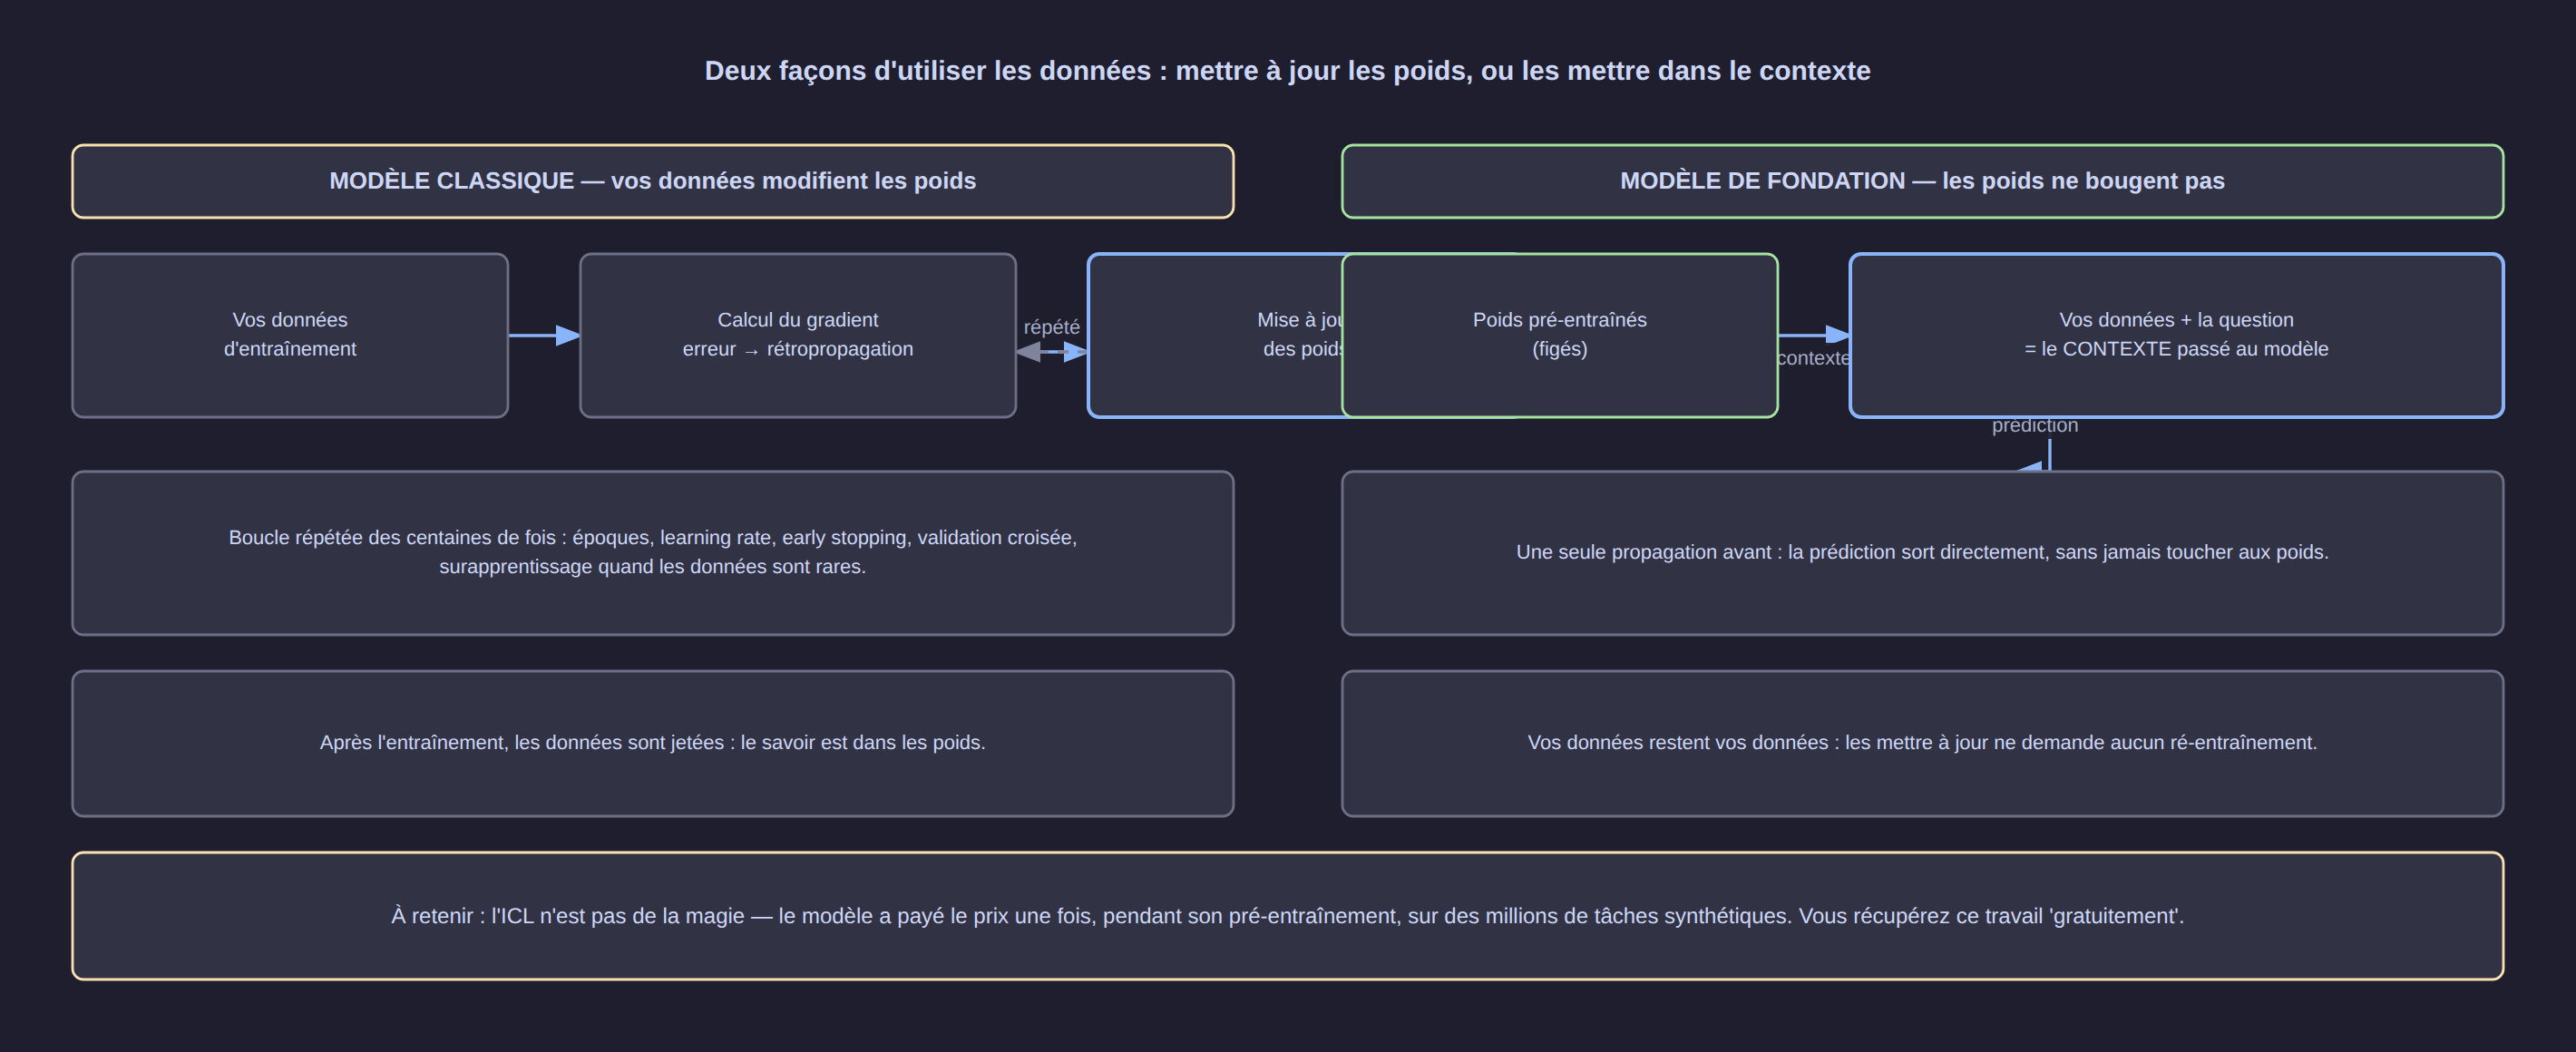
C'est la distinction la plus utile à retenir :
- Modèle classique : vos données servent à calculer un gradient, qui modifie les poids du modèle. On répète pendant des époques entières. À la fin, les données sont jetées : le savoir vit dans les poids.
- Modèle de fondation : les poids restent figés. Vos données voyagent avec la requête, comme un contexte. Changer de jeu de données ne demande aucun réentraînement.
En pratique, cela veut dire qu'une prévision pour une nouvelle région, un nouveau client ou une nouvelle année se fait en quelques secondes, pas en une nuit de calcul.
6. Le cas d'usage : une maison à Badoudou (Sokone), production PV contre consommation
6.1 La question posée
Une maison de 80 m², six personnes, près de Sokone : quelle puissance de panneaux et quelle capacité de batterie faut-il pour que la production solaire couvre la consommation, et un modèle de fondation peut-il aider à le prévoir ?
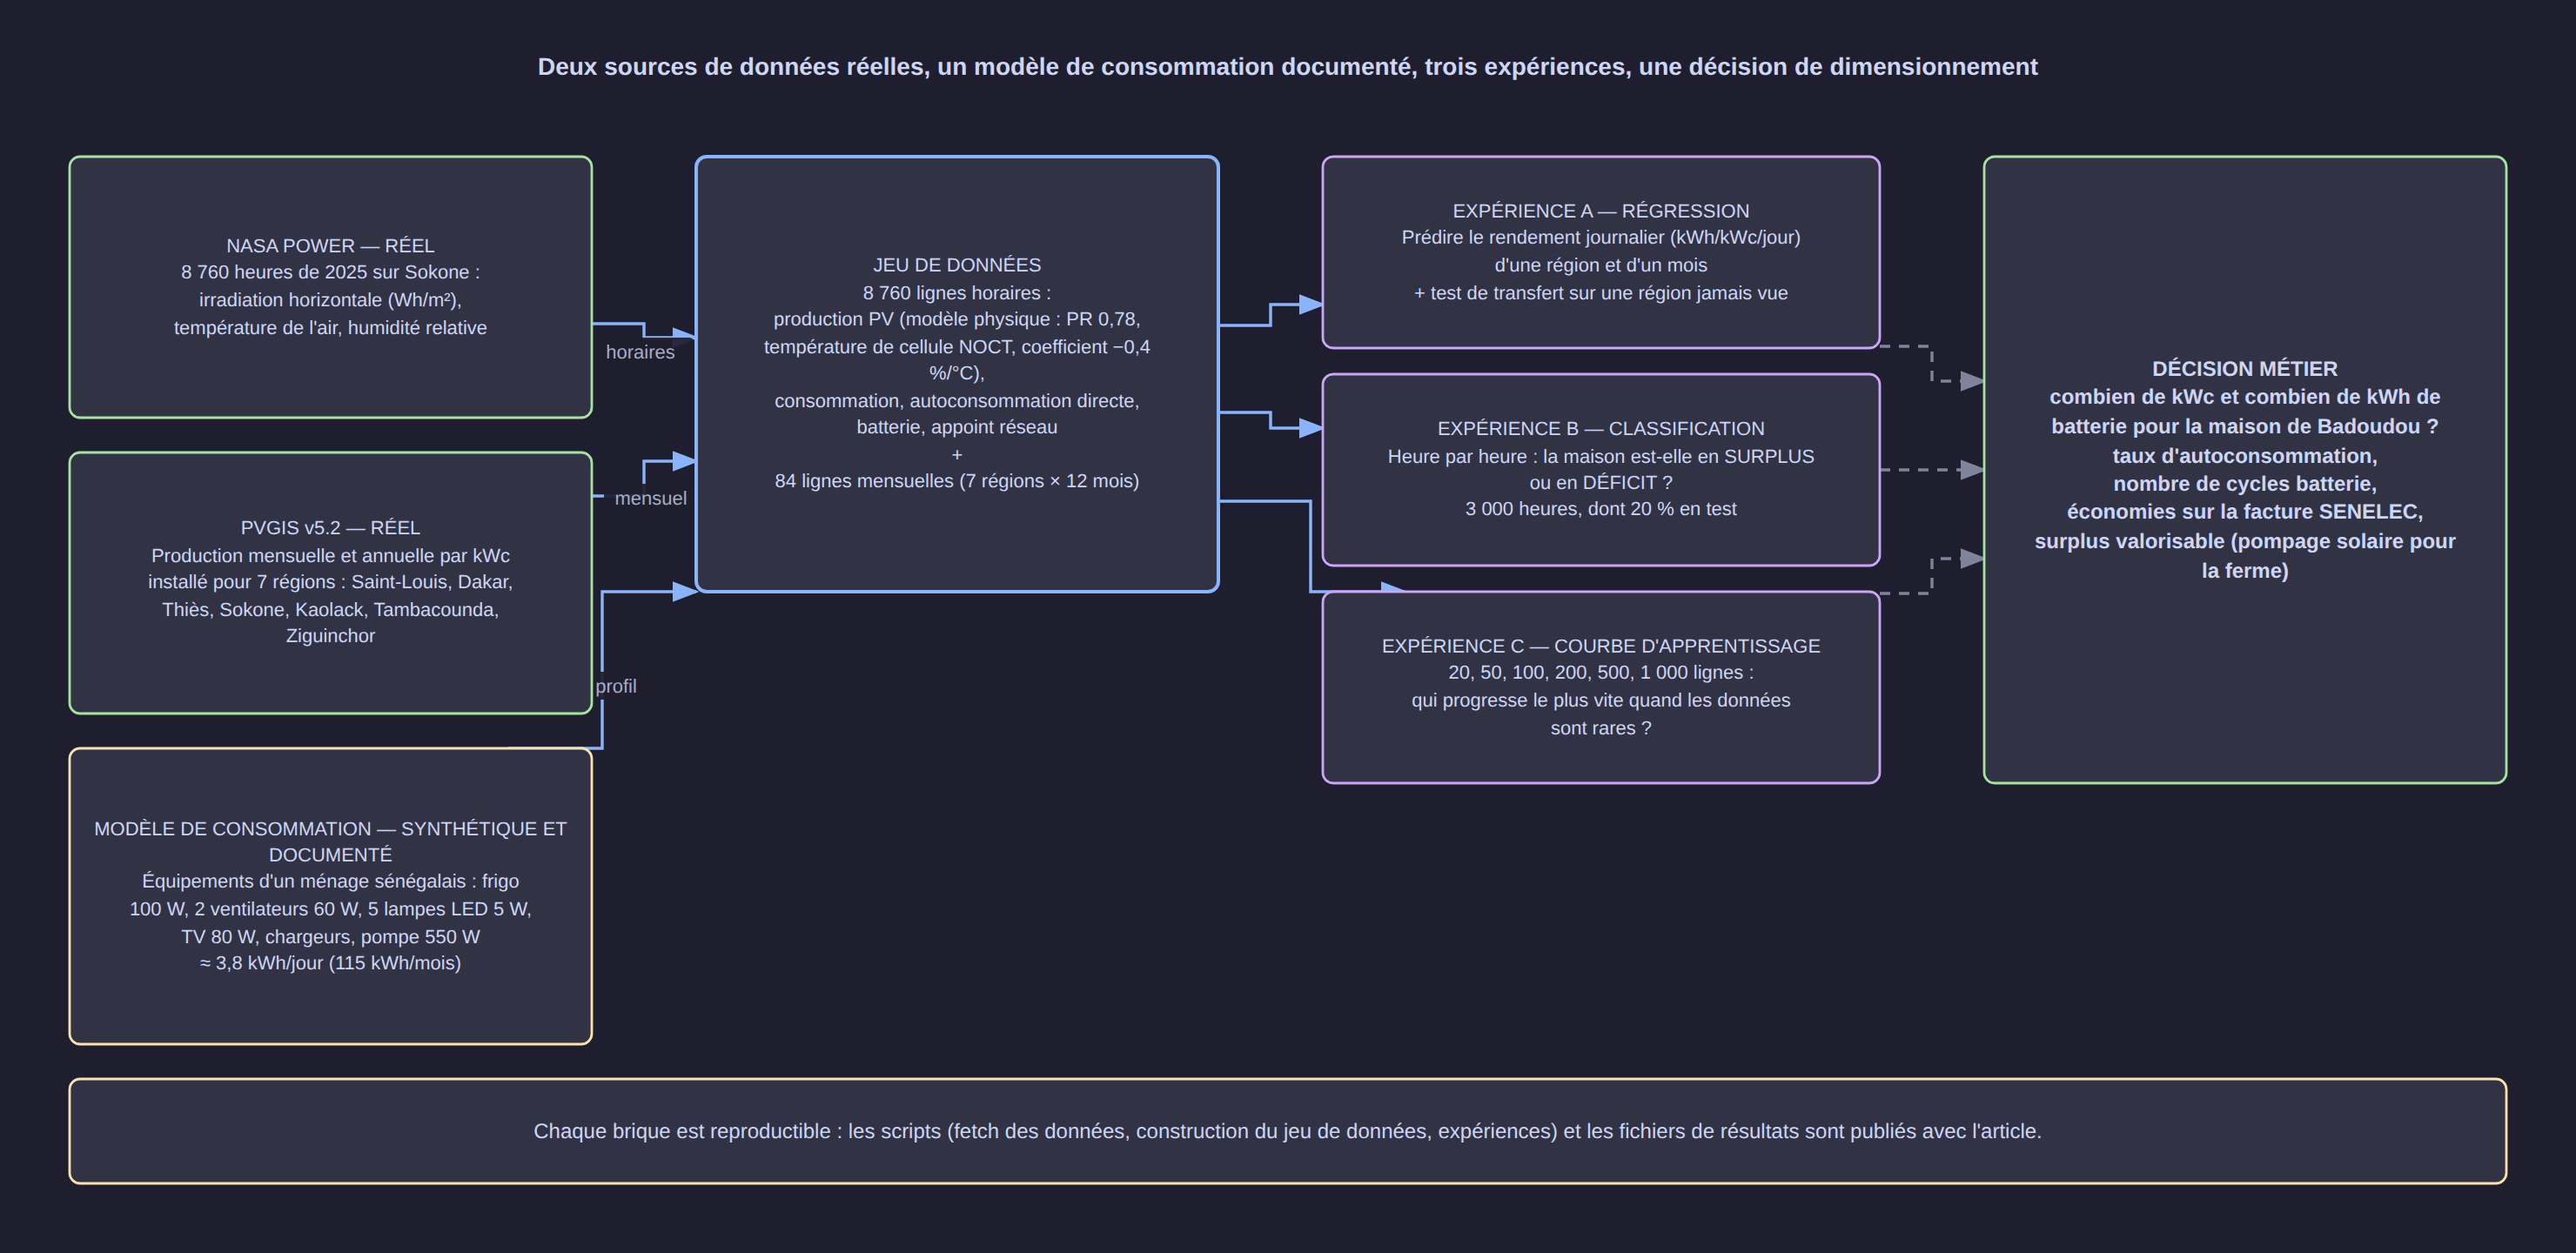
6.2 Les données : réelles d'abord, synthétiques seulement là où il faut
| Source | Nature | Contenu |
|---|---|---|
| NASA POWER (API publique) | Réel | 8 760 heures de l'année 2025 à Sokone (13,8767° N, −16,3597° O) : irradiation horizontale, température de l'air, humidité relative |
| PVGIS v5.2 (Commission européenne) | Réel | Production photovoltaïque mensuelle et annuelle par kWc pour 7 régions : Saint-Louis, Dakar, Thiès, Sokone, Kaolack, Tambacounda, Ziguinchor |
| Modèle d'équipements | Synthétique, documenté | Consommation d'un ménage sénégalais : réfrigérateur 100 W, deux ventilateurs 60 W, cinq lampes LED 5 W, téléviseur 80 W, chargeurs de téléphone, pompe 550 W |
Le profil de consommation est un modèle d'équipements, pas une mesure : chaque appareil a une puissance connue, une durée d'utilisation et une saisonnalité (ventilateurs pilotés par la température, éclairage plus long en saison des pluies, pompe en saison sèche). Résultat : ≈ 3,8 kWh par jour (115 kWh par mois), cohérent avec un ménage rural équipé.
La production photovoltaïque est calculée avec un modèle physique, pas inventée : puissance nominale × (irradiation / 1 000) × ratio de performance (0,78), avec dé-rating thermique (−0,4 %/°C, température de cellule estimée par le modèle NOCT à 45 °C).
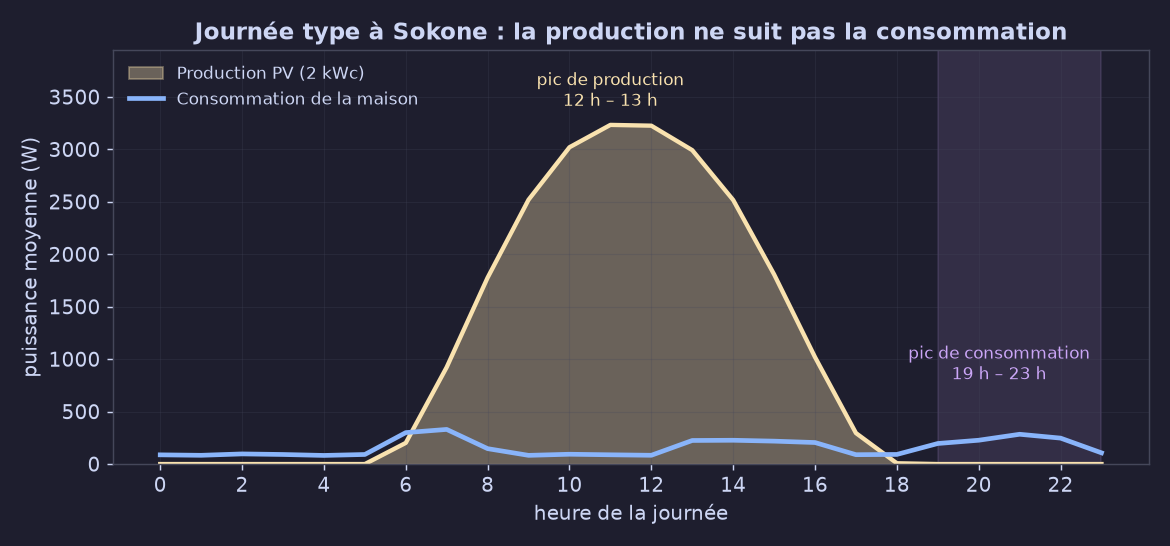
La figure ci-dessus est le cœur du problème : la production culmine à midi, la consommation à 20 h. Tout ce qui suit — batterie, surplus, dimensionnement — découle de ce décalage.
6.3 Le protocole d'expérience — la partie qui rend le résultat crédible
Trois expériences, toujours avec le même découpage entraînement/test pour tous les modèles :
- Expérience A — régression. Prédire le rendement journalier (kWh/kWc/jour) d'une région et d'un mois : 84 lignes (7 régions × 12 mois). Protocole 1 : découpage aléatoire 85/15. Protocole 2 : laisser une région entière hors de l'entraînement et la prédire — le vrai test de généralisation.
- Expérience B — classification. Heure par heure, la maison est-elle en surplus (production
consommation) ou en déficit ? 1 500 heures échantillonnées sur 8 760, 33 % en test.
- Expérience C — courbe d'apprentissage. 20, 50, 100, 200, 500 puis 1 000 lignes d'entraînement : qui progresse le plus vite quand les données sont rares ?
Modèles comparés : moyenne/classe majoritaire (référence naïve), régression linéaire, Random Forest, HistGradientBoosting (arbres boostés), et TabPFN v2 en zéro-shot — le modèle de fondation tabulaire de référence exécutable en local, de la même famille d'idée que TabFM (apprentissage en contexte, aucun entraînement sur les données de l'utilisateur).
[!NOTE] Pourquoi TabPFN et pas TabFM dans l'expérience ? TabPFN v2 s'exécute en local sur CPU avec des poids publics, ce qui rend l'expérience reproductible par n'importe qui. Les poids de TabFM sont sous licence non commerciale, et les versions récentes de TabPFN demandent une acceptation de licence et une clé API. Version utilisée : tabpfn 2.1.3. Les conclusions portent sur la famille de modèles (apprentissage en contexte), pas sur un éditeur.
6.4 Résultats
a) Découpage aléatoire (85 % entraînement / 15 % test)
Premier niveau de difficulté : les lignes sont mélangées, chaque modèle voit un peu de chaque région et doit prédire 13 lignes restantes.
| Modèle | MAE (kWh/kWc/jour) | RMSE | R² | Temps d'entraînement |
|---|---|---|---|---|
| Moyenne naïve (référence) | 0,150 | 0,243 | −0,01 | — |
| Régression linéaire | 0,126 | 0,159 | 0,56 | 0,01 s |
| HistGradientBoosting | 0,124 | 0,151 | 0,61 | 0,06 s |
| Random Forest | 0,067 | 0,093 | 0,85 | 0,23 s |
| TabPFN v2 zéro-shot | 0,025 | 0,030 | 0,98 | 0,43 s |
Avec 71 lignes d'entraînement, le modèle de fondation zéro-shot obtient R² = 0,98 et une erreur de 0,025 kWh/kWc/jour, soit 0,5 % de la production journalière moyenne — sans réglage, en 0,4 seconde, là où l'arbre boosté plafonne à R² = 0,61. Notez aussi la ligne « moyenne naïve » : son R² est négatif, ce qui signifie qu'elle fait pire que de prédire la moyenne — c'est la référence que tout modèle doit battre.
b) Prédire une région jamais vue — 84 lignes au total
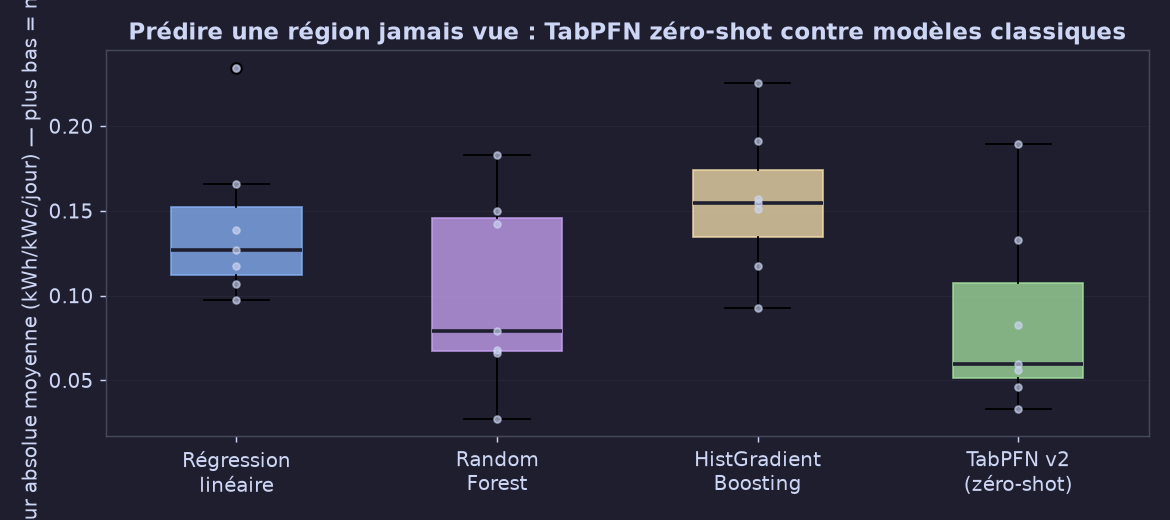
Le test le plus dur : on retire une région entière de l'entraînement (12 lignes) et on lui demande de prédire sa production. Aucun modèle n'a jamais vu cette région.
| Région mise de côté | Régression linéaire (MAE) | Random Forest (MAE) | HistGradientBoosting (MAE) | TabPFN v2 zéro-shot (MAE) |
|---|---|---|---|---|
| Dakar | 0,166 | 0,183 | 0,192 | 0,133 |
| Kaolack | 0,127 | 0,068 | 0,093 | 0,046 |
| Saint-Louis | 0,118 | 0,150 | 0,154 | 0,190 |
| Sokone | 0,098 | 0,027 | 0,151 | 0,033 |
| Tambacounda | 0,234 | 0,079 | 0,118 | 0,059 |
| Thiès | 0,139 | 0,066 | 0,157 | 0,083 |
| Ziguinchor | 0,107 | 0,142 | 0,226 | 0,056 |
| Moyenne | 0,141 | 0,102 | 0,156 | 0,086 |
L'unité est le kWh par kWc et par jour. La consommation moyenne du jeu de données étant de 4,7 kWh/kWc/jour, une erreur de 0,086 correspond à environ 1,8 % d'erreur relative.
Traduit en clair :
- TabPFN zéro-shot obtient la meilleure erreur moyenne (0,086) sans aucun réglage, devant un Random Forest réglé à la main (0,102) et un arbre boosté (0,156). Son R² moyen est de 0,93.
- Nuance essentielle : il perd sur Saint-Louis (0,190 contre 0,150 pour le Random Forest) — la région la plus productive, celle qu'il doit extrapoler le plus loin de ce qu'il a vu. Un modèle de fondation n'est pas magique : il est excellent dans l'interpolation, plus fragile aux extrêmes.
- La régression linéaire n'est pas ridicule (0,141). C'est le rappel qu'une référence simple doit toujours figurer dans la comparaison : sans elle, on ne sait pas si le modèle sophistiqué apporte quoi que ce soit.
c) Prédire heure par heure : surplus ou déficit ?
La question opérationnelle — « à cette heure-là, la maison produit-elle plus qu'elle ne consomme ? » — sur 1 500 heures échantillonnées dans l'année, un tiers gardé pour le test (500 heures).
| Modèle | Exactitude | F1 (classe « surplus ») | AUC | Temps d'entraînement | Temps de prédiction |
|---|---|---|---|---|---|
| Classe majoritaire (référence naïve) | 55,6 % | 0,000 | — | — | — |
| Régression logistique | 99,39 % | 0,993 | 0,9998 | 0,01 s | < 0,01 s |
| Random Forest | 99,60 % | 0,996 | 0,9999 | 0,36 s | 0,02 s |
| HistGradientBoosting | 99,80 % | 0,998 | 1,0000 | 0,11 s | 0,01 s |
| TabPFN v2 zéro-shot | 100,00 % | 1,000 | 1,0000 | 0,16 s | 472 s |
Ce que ce tableau enseigne — et c'est plus important que le classement : quand la cible est presque déterministe (le surplus est défini par production > consommation, et les deux sont quasiment connus dans les variables d'entrée), tous les modèles sérieux sont excellents. Le modèle de fondation obtient 100 % — mais il met 472 secondes à prédire 500 lignes sur un CPU, contre 0,01 seconde pour une régression logistique qui atteint 99,4 %.
[!IMPORTANT] La bonne question n'est pas « quel modèle gagne ? » mais « quel modèle gagne assez, pour quel coût ? ». Un modèle de fondation est précieux quand vos données sont rares et le problème difficile ; il est superflu quand une droite sépare déjà les classes. Ici, la différence entre 99,4 % et 100 % ne vaut probablement pas un temps d'inférence multiplié par 40 000.
d) Combien de lignes faut-il vraiment ?
C'est l'expérience la plus instructive des trois : on entraîne les mêmes modèles avec 20, 50, 100, 200, 500 puis 1 000 lignes, et on mesure l'exactitude sur le même jeu de test.
| Lignes d'entraînement | Random Forest | HistGradientBoosting | TabPFN v2 zéro-shot |
|---|---|---|---|
| 20 | 95,96 % | 55,56 % | 97,17 % |
| 50 | 95,56 % | 94,34 % | 98,79 % |
| 100 | 96,36 % | 99,39 % | 99,80 % |
| 200 | 98,79 % | 99,39 % | 99,80 % |
| 500 | 98,99 % | 99,60 % | 100,00 % |
| 1 000 | 99,60 % | 99,80 % | 100,00 % |
Lecture : dès 20 lignes, le modèle de fondation zéro-shot est déjà à 97,2 % — alors que l'arbre boosté est à 55,6 % (il n'arrive pas à apprendre avec aussi peu de données) et que le Random Forest a besoin de 200 lignes pour atteindre un niveau comparable. C'est exactement le régime de fonctionnement des petits projets : un terrain, une maison, un client, un capteur. Le modèle de fondation n'est pas seulement « aussi bon » : il est utilisable beaucoup plus tôt.
6.5 Ce que le modèle doit vraiment prédire : le dimensionnement
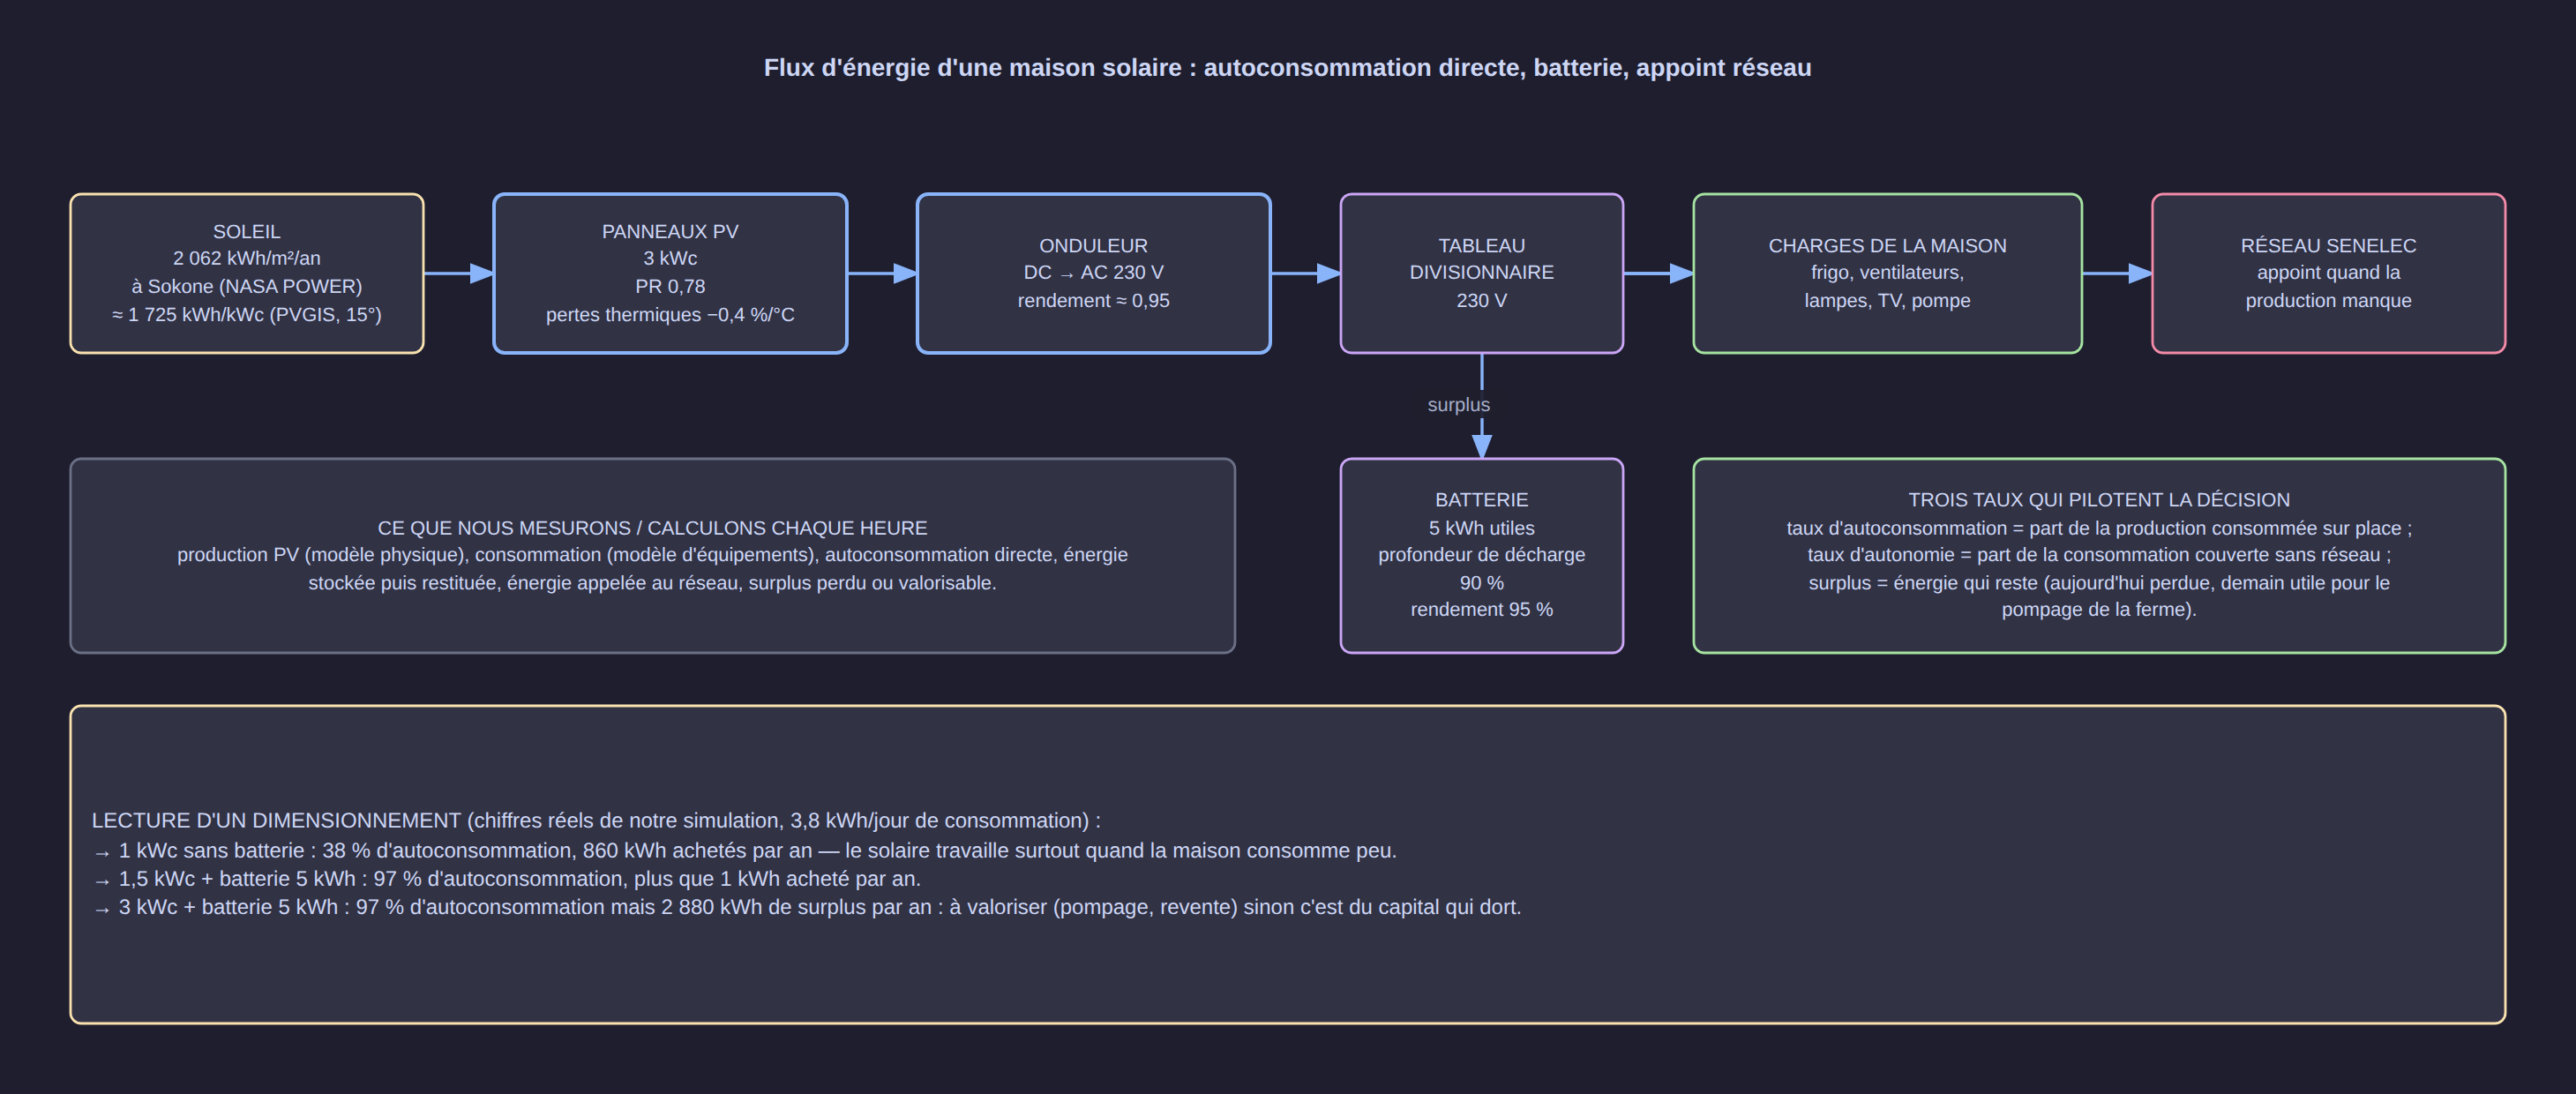
Une fois la production et la consommation modélisées heure par heure, la question de dimensionnement devient un simple bilan d'énergie.
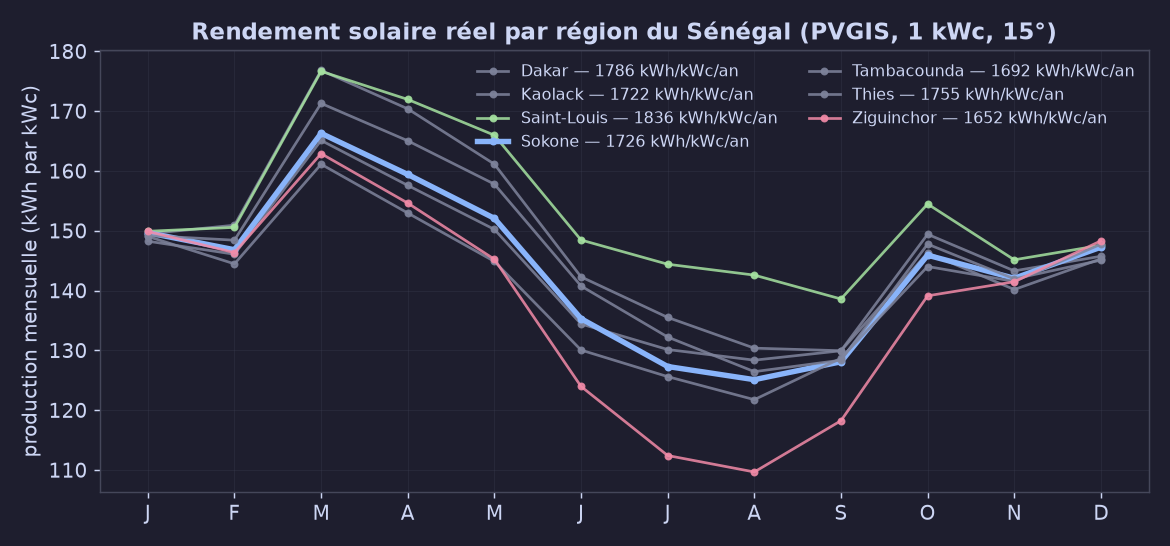
L'écart régional est réel : Saint-Louis produit 1 836 kWh par kWc et par an, Ziguinchor 1 652, soit 11 % d'écart entre le meilleur et le pire site — de quoi changer un dimensionnement.
Simulation complète sur 8 760 heures, batterie de 5 kWh (profondeur de décharge 90 %, rendement 95 %) :
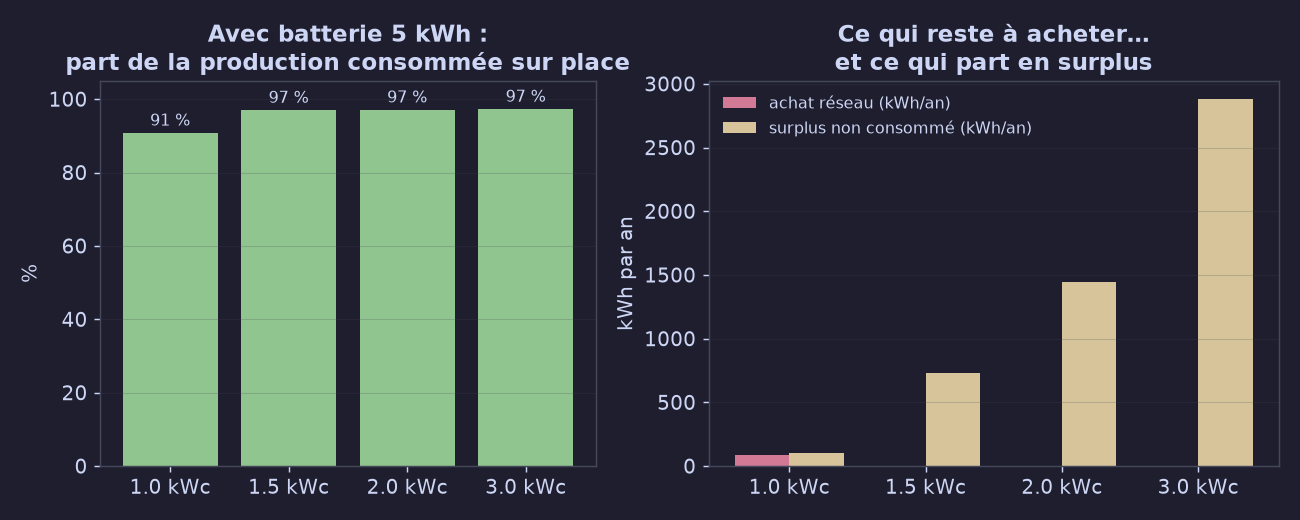
| Puissance installée | Sans batterie : autoconso | Sans batterie : achat réseau | Avec batterie 5 kWh : autoconso | Avec batterie : achat réseau | Surplus annuel |
|---|---|---|---|---|---|
| 1,0 kWc | 37,6 % | 860 kWh | 90,8 % | 88 kWh | 101 kWh |
| 1,5 kWc | 41,3 % | 809 kWh | 97,0 % | 1 kWh | 728 kWh |
| 2,0 kWc | 43,5 % | 779 kWh | 97,1 % | 1 kWh | 1 446 kWh |
| 3,0 kWc | 46,4 % | 739 kWh | 97,3 % | 0,5 kWh | 2 880 kWh |
Trois enseignements, valables bien au-delà du Sénégal :
- Sans stockage, le solaire travaille quand la maison ne consomme pas. Le pic de production est à midi, le pic de consommation à 20 h.
- La batterie change tout : l'autoconsommation passe de ~40 % à 90–97 %.
- Surdimensionner n'apporte rien à la maison : à partir de 1,5 kWc, l'achat réseau est déjà quasi nul ; les kilowatts supplémentaires partent en surplus. Ce surplus a une valeur — pompage solaire pour l'irrigation, éclairage extérieur, atelier — mais seulement s'il est utilisé.
6.6 Combien ça économise, en francs CFA
Tarifs SENELEC applicables au 1er janvier 2026 (grille approuvée, catégorie Domestique Petite Puissance) :
| Tranche mensuelle | Prix de l'énergie |
|---|---|
| 0 à 150 kWh | 82,00 FCFA/kWh |
| 151 à 250 kWh | 136,49 FCFA/kWh |
| Plus de 250 kWh | 159,36 FCFA/kWh |
(la 1ʳᵉ tranche a baissé de 10 % au 1ᵉʳ janvier 2026 ; s'y ajoute une prime fixe mensuelle selon la puissance souscrite et une redevance d'électrification rurale de 0,7 FCFA/kWh déjà intégrée)
Avec une consommation de 1 378 kWh/an, toute la consommation reste dans la première tranche :
- consommation annuelle à couvrir : 1 378 kWh × 82 FCFA ≈ 113 000 FCFA par an ;
- avec 1,5 kWc + batterie 5 kWh, l'achat réseau tombe à ~1 kWh/an : l'économie annuelle est donc de l'ordre de 113 000 FCFA (hors prime fixe).
Autrement dit : le solaire remplace surtout une facture modeste mais réelle, et sa rentabilité dépend du prix du kit installé, pas des kWh économisés. C'est un calcul à refaire avec un devis réel — le surplus qui n'est pas valorisé est, lui, un investissement qui dort.
7. Quand utiliser un modèle de fondation (et quand l'éviter)
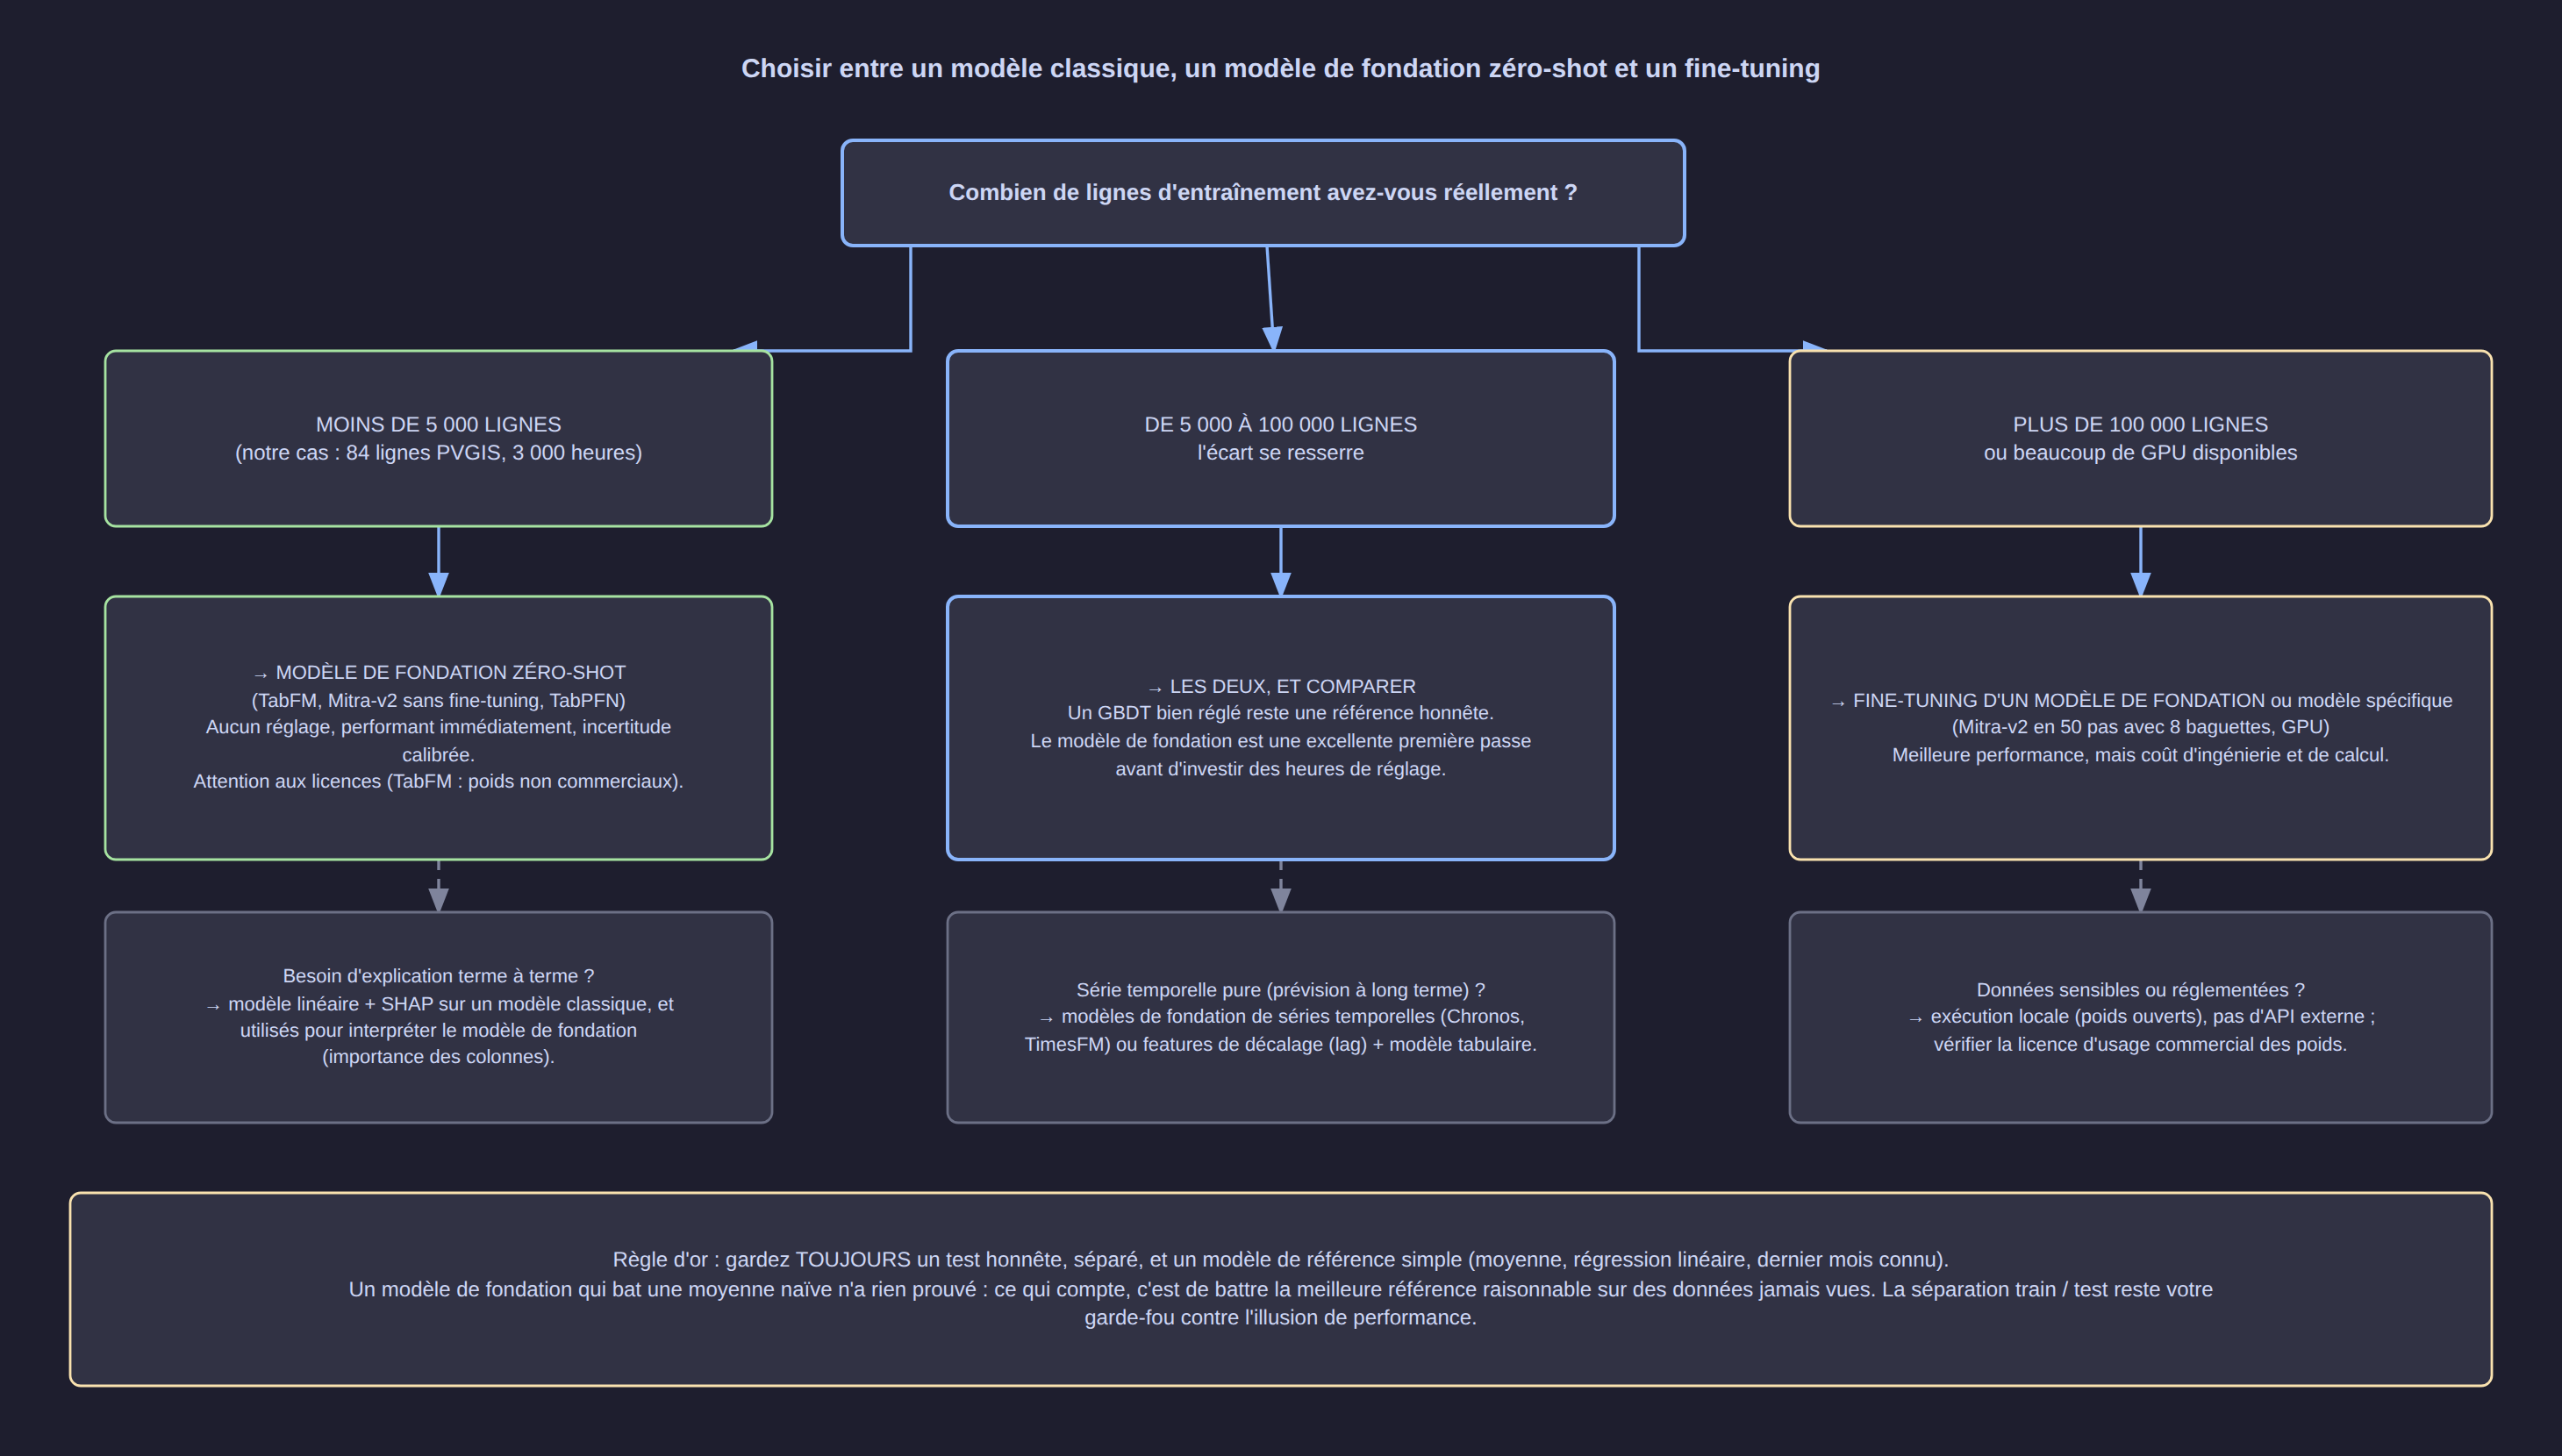
- Moins de quelques milliers de lignes (notre cas) → un modèle de fondation zéro-shot est pertinent : performant immédiatement, incertitude souvent mieux calibrée, zéro réglage.
- Entre quelques milliers et quelques centaines de milliers de lignes → faites les deux et comparez : un arbre boosté bien réglé reste une référence redoutable.
- Gros volumes ou contraintes de production → le fine-tuning d'un modèle de fondation (voir l'article sur Amazon Mitra-v2) ou un modèle spécifique, entraîné à votre domaine.
- Séries temporelles pures (prévoir la production des 30 jours à venir) → modèles de fondation dédiés aux séries temporelles, ou variables de décalage + modèle tabulaire (notre expérience B).
8. Limites et pièges à connaître
- Un modèle de fondation n'est pas une preuve. Il donne une première réponse rapide et souvent bonne ; il ne dispense pas d'un jeu de test séparé et honnête.
- Le contexte coûte de la mémoire. Ces modèles passent toutes vos lignes d'entraînement à chaque prédiction : la consommation mémoire croît avec le nombre de lignes. C'est fait pour la petite et moyenne donnée, pas pour des millions de lignes.
- Licences. TabFM : poids non commerciaux. TabPFN récent : acceptation de licence et clé API. Mitra-v2 : Apache-2.0 (poids, code d'inférence, code de fine-tuning).
- Les données synthétiques sont un choix, pas un détail. Le modèle apprend les régularités de ses priors : un domaine très particulier (capteurs industriels exotiques, texte, images) reste hors de son terrain.
- Une ligne « moyenne » peut tromper. Sur des données aussi structurées que 84 lignes de production solaire, une courbe déterministe fait déjà une grande partie du travail : le mérite du modèle est de s'en approcher sans réglage, pas de faire de la magie.
9. Reproduire l'expérience
Les scripts de cette étude suivent un ordre simple :
1. fetch_solar_data.py   → télécharge NASA POWER (horaire) et PVGIS (mensuel) pour 7 régions
2. build_dataset.py      → construit la base horaire (8 760 lignes), le modèle de consommation,
                           le bilan batterie/réseau et les scénarios de dimensionnement
3. run_experiment.py     → expériences A, B, C (références naïves, modèles classiques, TabPFN zéro-shot)
4. export_site_data.py   → publie les données et résultats en JSON pour le portail web
Les données et les graphiques interactifs sont publiés sur data-science.pauldiop.com, et les
fichiers sources de chaque diagramme (.drawio) accompagnent cet article : cliquez sur un
diagramme pour l'ouvrir en grand, puis éditez le .drawio correspondant.
10. À retenir
- Un modèle de fondation tabulaire est pré-entraîné sur des millions de tables synthétiques : il prédit vos données en les mettant dans le contexte, sans entraînement ni réglage.
- Sur 84 lignes ou 1 500 heures, ce type de modèle est directement exploitable — ce qui laisse le temps à la partie qui compte vraiment : formuler la bonne question métier.
- Pour une maison à Sokone, l'essentiel du gain vient du couple production + batterie, pas du surdimensionnement : 1,5 kWc + 5 kWh suffisent à couvrir une consommation de 3,8 kWh/jour à plus de 97 %.
- L'économie réelle se lit à la tranche SENELEC (82 FCFA/kWh en 2026 pour les 150 premiers kWh mensuels) : le solaire remplace une facture modeste — à comparer au devis d'installation.
Ressources
- Fiche et code du modèle : Google TabFM (GitHub) et poids sur Hugging Face
- Communication de Google Research : Introducing TabFM
- Modèle utilisé dans l'expérience : TabPFN (Prior Labs)
- Données solaires : NASA POWER et PVGIS (JRC)
- Tarifs électricité : grille tarifaire SENELEC applicable au 1ᵉʳ janvier 2026 (CRSE)
- Article compagnon : Amazon Mitra-v2 — Modèles de fondation tabulaires et fine-tuning